Nace AI 把计算机操作智能体的调用成本压到了千次 0.06 美元,响应速度压到了 183 毫秒。
代价是彻底切除大模型的逐字生成能力。从参数量 8.95B 的纯文本判别器 Drex 1.5,到专用于桌面操作的多模态模型 Drex Max,Nace AI 持续在做同一件事:不输出对话,不写思维链,只让模型在屏幕截图和预设选项里打勾做选择题。
把生成式大模型阉割成离散判别器,切中了智能体落地时的高延迟与高成本死穴。但撕开跑分榜首的标签,这种工程改造更像是一次精心计算的田忌赛马:它在专用选择题基准里微弱领跑,一旦拉到真实的端到端桌面操作,依然打不过通用旗舰。
放弃逐字生成:183毫秒换来的工程套利
在智能体协作与图形界面自动化中,工程师常常卡在两难境地。通用多模态大模型每看一张截图都要自回归推理解析,单步耗时动辄数秒,还伴随格式崩坏与幻觉。
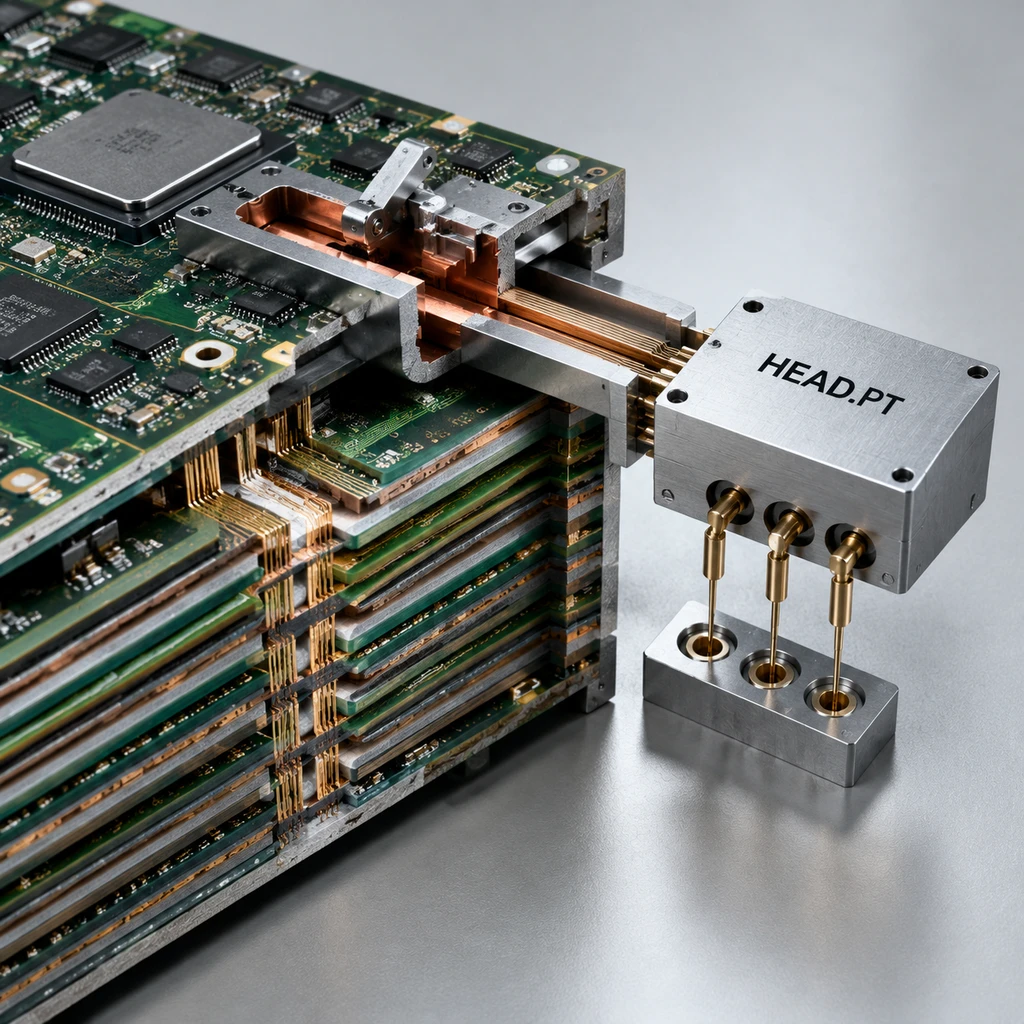
Nace AI 摸索出一条极其特化的工具化路径。其早前推出的纯文本模型 Drex 1.5 基于 XiaomiMiMo 架构蒸馏,底层维持 32 层混合注意力骨干网,输出端直接外挂独立的 head.pt 指针头,把预测下一个词的逻辑,改造为单次前向传播的离散概率打分。
最新推出的多模态版本 Drex Max 将这种特化推向极致。它吃进屏幕截图与预设问题,吐出分类概率,把操作拆解、候选选项生成和键鼠指令分发全部甩给外部宿主框架。
解耦带来的账面红利立竿见影。Drex Max 的中位决策延迟压缩至 183 毫秒,千次决策成本仅需 0.06 美元。对比之下,Claude Opus 5.5 耗时 3.5 秒、千次成本 10.17 美元;GPT-6 Sol 耗时 2.0 秒、千次成本 3.33 美元。
天下武功,唯快不破。对于要在桌面环境里频繁试错、反复跳转界面的高频工作流,让慢速大模型做宏观规划,把单步选择丢给专用判别器,在工程逻辑上确实成立。
跑分幻象与偏科:选择题并不等于真实操刀
速度再快,做错决定依然是徒劳。
Drex 系列标榜的高分往往经不起细看。在专用的离散决策基准里,Drex 1.5 拿到 58.08 分,微弱领先第二名 0.12 分,完全落在测试仪器的并列公差带内;到了 Drex Max,其在 Decision Index 0.3.2 拿出了 67.59 分,拉开竞品 6.89 分。
但专用基准测的是预先裁好的单步选择题,而非真实世界的桌面环境。
一旦切到考验端到端操作能力的实操基准 OSWorld,Drex Max 立刻现出原形。在 OSWorld-Verified 评测中,Drex Max 得分 78.0%,不敌 Claude Opus 5.5 的 79.0%;在 OSWorld-V2 上,Drex Max 得分 73.7%,同样落后于 Claude 的 76.1% 和 GPT-6 Sol 的 74.4%。
这种差距早在 Drex 1.5 上就已显露。Drex 1.5 在纯工具调用项能拿到 75.0 分,但在知识推理项跌至 44.6 分。当模型只负责打分,它其实把最沉重的长因果链条推理全部甩给了外部环境。一旦外部框架提供的候选选项有偏差,它只会在几个坏选项里精准挑出一个看似概率最高的错误答案。
更耐人寻味的是评测透明度。Decision Index 的完整评价体系由 20% 公开测试、50% 同技能私有测试和 30% 新领域私有测试构成。Nace 拿来宣传的 67.59 分,全部来自那 20% 的公开基准。
在语料库标准请求量为 110,201 次的测试中,Nace 实际跑了 140,178 次已评分请求。这多出来的近 3 万次请求到底包含了怎样的重试策略与过滤手段,官方至今没有披露白皮书。训练集里直接掺杂测试基准公开切片的做法,在新旧两代模型上一脉相承。
商业防守与私有分支:伪开源的隐形账单
技术路线高度偏门,商业授权同样筑起了高墙。
在 Drex 1.5 发布时,Nace AI 就展现出极强的防守姿态。虽然代码以 Apache-2.0 协议开源,但核心模型权重套上了定制版 Nace.AI Open RAIL-M License。
这份条款给企业设下了双百万门槛:过去 12 个月内总营收超过 100 万美元,或累计融资超过 100 万美元,必须向 Nace 签署独立书面许可,同时严禁竞对使用。这不是纯粹的开源,而是带着商业栅栏的受限权重开放。
部署体验同样充满排他性。开发者想在本地跑起这类指针模型,无法直接接入官方主干的 llama.cpp 或 Ollama,必须使用 Nace 维护的私有分支代码。
到了 Drex Max,这种控制收拢得更彻底,直接转向以 API 计费为主的交付模式。
把大模型从端到端生成改造为离散打分器,确实在工程效率上撕开了一道口子。然而《淮南子》有言:“规矩者,方圆之极;法令者,清浊之标。”测试基准是丈量技术的尺,当尺子本身只拆公开切片、请求数据存在 3 万条公差、推理深度靠外部宿主掩护时,漂亮的毫秒数并不能抹平实操代差。
对于正在搭建自动化系统的团队,Drex 的解耦思路值得参考,但当下盲目把业务底座押注在私有协议和偏科严重的专用判别器上,省下来的算力成本,最终都会变成后期架构重构与商务谈判的过路费。