AI推理服务商Baseten在2026年10月29日发布了2B参数的决策模型joey-1,每百万输入Token定价0.01美元,缓存输入与输出Token标价均为0.00美元。这颗基于Qwen3.5-2B微调、支持图文输入的轻量模型不负责写文章或写代码,专门承接分类、模型路由和安全护栏检查等高频判断任务;在平均2,000 Token的生产请求下,其端到端P50延迟压到了20毫秒,比同家族更大体积的elephant-1(49毫秒)快约2.5倍。
光看1美分和20毫秒很容易误以为这只是一次常规的小模型算力降价,但真正值得拆解的是输出Token免费背后的机制变化,以及它在精度、上下文和评测口径上的隐性代价。在Jev Decision Index 0.4公开子集上,joey-1得分为63.30分(230个模型中排第37位),明显低于同门师兄elephant-1的72.24分;它从来不是用来独当一面的主力模型,而是Baseten放在企业AI流水线最前端的高速分流器。
输出Token凭什么标价0美元
通用大语言模型哪怕只回答一个是或否,通常也要走完标准的自回归解码(Decode)流程,逐Token生成文本,这也是API账单里输出Token往往比输入贵数倍的原因。在企业级Agent工作流里,意图识别、内容合规审查、重排序打分这些前置动作每天要跑数百万次,用通用生成式模型去跑纯属杀鸡用牛刀,既慢又烧钱。
joey-1直接砍掉了自由文本生成能力。它沿用了Baseten此前训练elephant-1与mammoth-1的数据配比和配方,通过Baseten Training Jobs完成训练后处理,将模型改造成纯粹的单步概率提取器。面对输入的文本或图像,模型只做单次前向传播(one forward pass),直接返回结构化选项、是非判断、有序打分以及对应的概率分布。
因为根本没有多步自回归解码阶段,推理服务端几乎不产生解码算力消耗。Baseten索性把输出Token和缓存输入定为0美元,只收预填充(Prefill)阶段每百万Token 0.01美元的过路费。
砍掉逐字生成的解码环节,输出零收费本质是只收预填充的算力钱。
对正在搭建多Agent系统的工程团队来说,这种形态比传统BERT分类器更灵活(支持图文多模态输入和零样本/少样本指令定义),又比调用小号生成式LLM省去了格式解析失败和解码排队的时间。
20毫秒与榜首光环下的三处限制
厂商宣传页上的极限数字,拿到生产环境里往往要打折扣。如果团队打算把现有的路由或审核模块切到joey-1,有三个单看标题意识不到的限制条件必须提前算进账本。
| 评估维度 | Baseten 官方主打口径 | 实际落地限制与附加条件 |
|---|---|---|
| 上下文窗口 | 支持最高 262K 上下文 | 共享 API 仅限 16K;用满 262K 必须购买专属部署 |
| 响应延迟 | 端到端延迟低至 20 毫秒 | 仅为 2,000 Token 平均请求下的 P50,未披露 P95/P99 长尾指标 |
| 榜单成绩 | 3B 及以下最强、2B 模型榜首 | 内部测试细节未公开,对比图实为内部复现(Internal Replica) |
上下文缩水是最直接的门槛。共享API(0.01美元/百万Token档位)实际只支持16K上下文;如果业务涉及长文档合规审查或超长对话历史路由,想要解锁官方宣传的262K上下文,就必须掏钱上专属部署(dedicated deployment),计费逻辑将彻底改变。
延迟和跑分同样存在信息盲区。官方给出的20毫秒是2,000 Token请求下的中位数(P50)表现,而生产级路由器和护栏最怕长尾卡顿,目前Baseten尚未披露P95或P99延迟数据,且宣称“比同类可比决策模型快5倍”时也未具名对比对象。至于“3B及以下最强决策模型”的头衔,其引用的Artificial Analysis对比图表角落标注着“Internal Replica(内部复现)”,并非第三方独立评测机构的背书;目前Hugging Face上的baselabs/joey-1模型卡页面也未能正常加载,Reddit与Hacker News上尚无独立社区实测验证。
- 风险.把joey-1当成全能判官直接替换线上审核模型会踩坑,63.30分的公开榜单成绩说明2B体量在复杂逻辑判断上存在明显的精度天花板。
1美分守门员背后的分级漏斗算盘
既然joey-1在Jev Decision Index 0.4上的得分(63.30)比自家大哥elephant-1(72.24)低了近9分,Baseten为什么要花力气推这颗小模型?答案藏在决策模型特有的输出概率里。
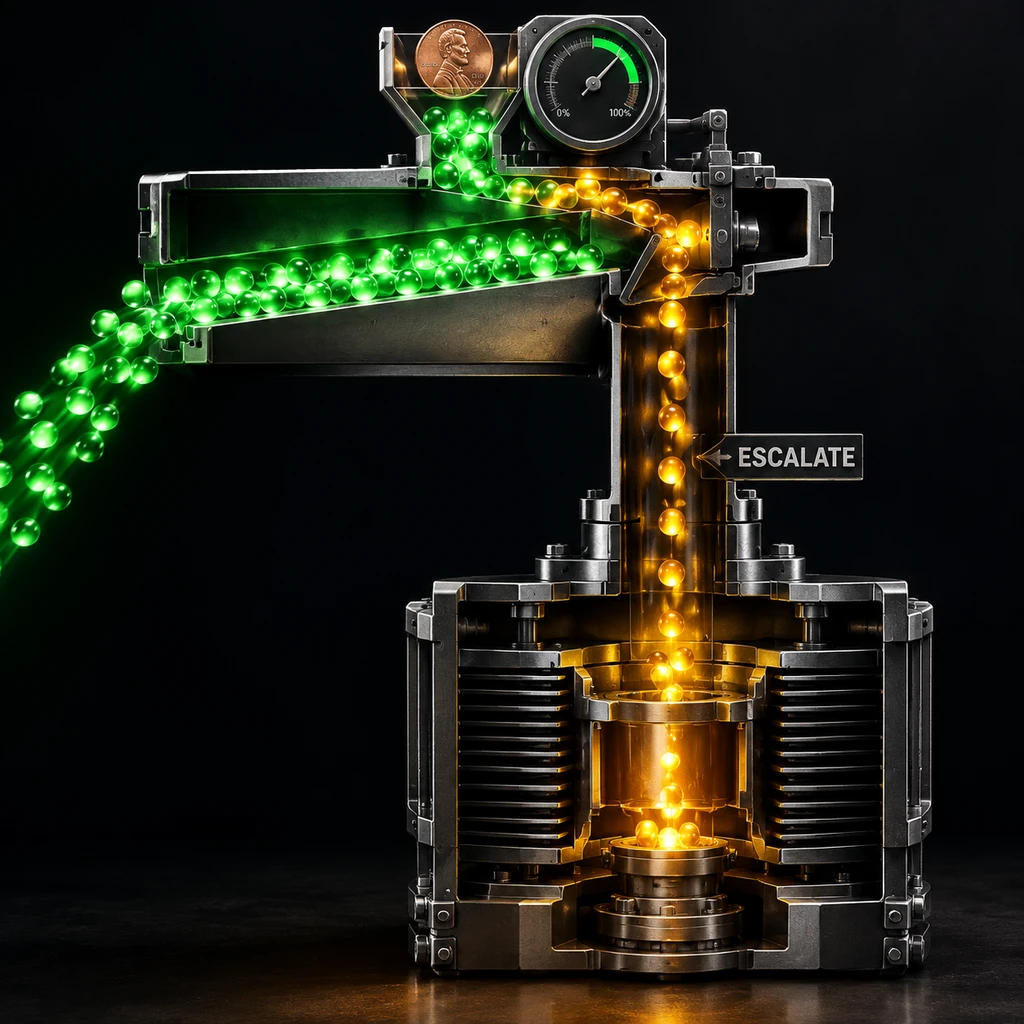
因为joey-1每次返回结果时都会附带校准后的概率值,Baseten给企业客户设计的标准用法是分级路由:让joey-1以每百万Token 1美分的价格拦在所有流量的最前面,处理80%简单明确的是非判断与分类;一旦模型输出的概率分布显示它拿不准(置信度低于阈值),或者遇到高风险合规请求,系统就自动将请求向上升级(escalate),无缝转交给Baseten平台上更贵、更准的elephant-1或mammoth-1。
对Baseten而言,joey-1是一枚卡住企业AI工作流入口的棋子——只要开发者为了贪图20毫秒和0.01美元把路由层和护栏层切到Baseten的API上,后续被筛出来的复杂请求自然会顺着管道流向它家的高毛利大模型与专属部署服务。对架构师来说,眼下最该盯紧的两个待验证变量,一是Hugging Face模型卡恢复后披露的具体评测集构成,二是joey-1输出概率的真实校准度(Calibration)——毕竟如果一个守门员连自己不知道都判断不准,再便宜的分级漏斗也会漏水。