Edge0 刚刚开源了零样本语音克隆模型 Audio8-TTS-Realistic-0.6b,主模型参数量只有 601M(不含 44.1 kHz 神经音频编解码器),采用 Apache 2.0 协议,支持 23 种语言。最抓人眼球的是它的越级跑分:在 CV3 九语言基准测试中,它交出了 4.86% 的平均错误率,直接压过了参数量大两三倍的 Qwen3-TTS-1.7B(7.73%)、CosyVoice3-1.5B(6.89%)和 VoxCPM2(5.35%)。但如果翻开底层评测仓库,你会发现这张成绩单藏着明显的偏科:它在中英常规测试里稳居第一梯队,到了生僻绕口的困难中文(Hard Chinese)和粤语场景却直接垫底。
对于正在找轻量化语音底座的开发者来说,这台小钢炮的边界非常清楚:它靠精巧的强化学习设计把常规多语言停顿节奏做到了越级水准,但音色克隆相似度(SIM)依然落后于 1.5B 以上的开源主力,且网传的苹果 M2 芯片 1.1 GiB 内存占用其实是前代旧模型的测试数据,新版目前还得老老实实跑在 GPU 上。
三百万参数的裁判,怎么封死强化学习的投机路数
语音合成模型过了把字读准(低 WER)和音色像(高 SIM)的门槛后,剩下的难关都在呼吸、停顿和语速节奏。Audio8-TTS-Realistic 在架构上复刻了 Fish Audio S2 Pro 的双自回归(DualAR)设计:慢分支拿 Qwen2.5 0.5B 做骨干(24 层、宽度 896),以每秒约 21.5 帧的速度预测文本与第一层主音频码本;4 层的浅层快分支再并行吐出剩余 9 个码本。把序列计算锁死在帧级别,才让 0.6B 的体量撑起了 2,048 的上下文长度。
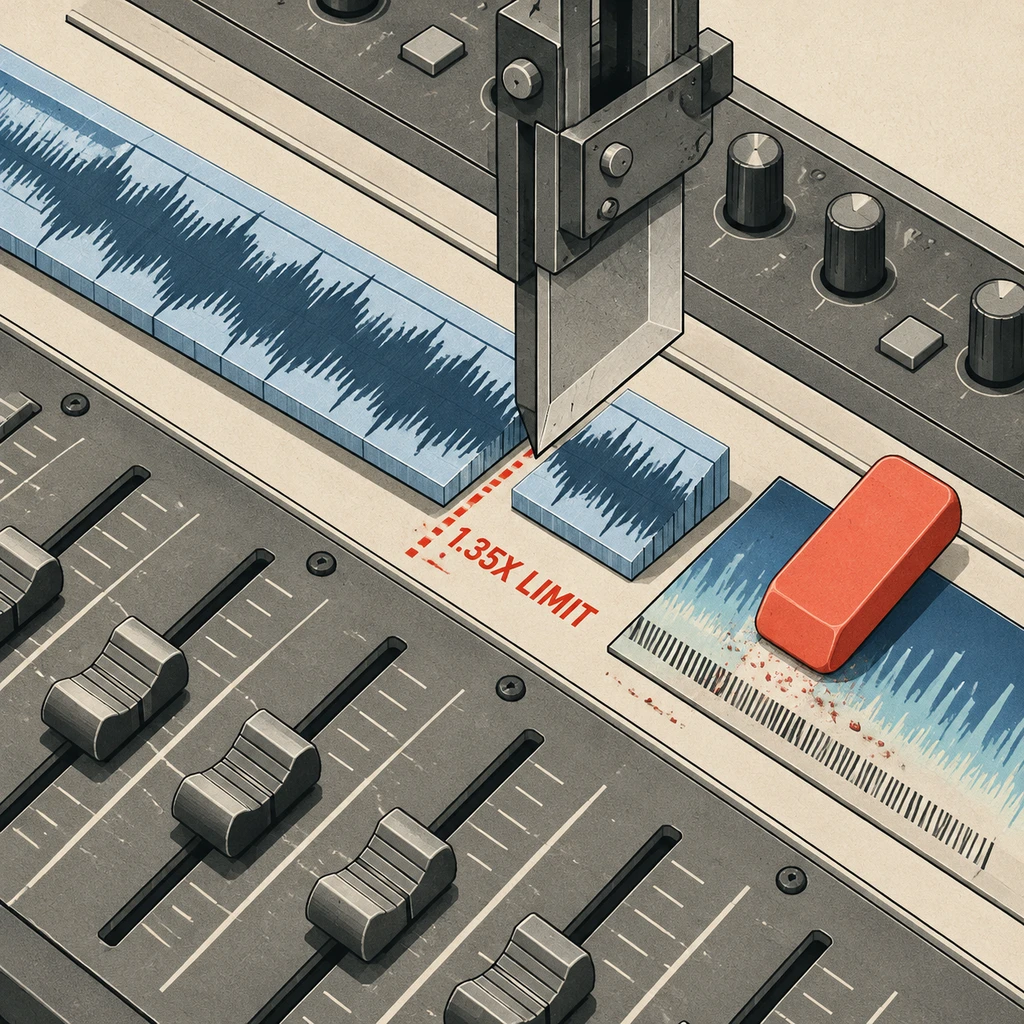
真正的巧思在后训练的第三阶段。把强化学习(GRPO)引入语音生成时,策略模型极易钻空子——要么故意拉慢语速把每个字咬得死板来骗取低错误率,要么在音频里夹带特定的合成器伪影,去讨好同源的奖励模型。
韩非子讲“法立则弊生”,只要考核指标固定,被考核者一定会顺着规则漏洞长出畸形动作。Edge0 的解法是专门训练了一个只有约 3M 参数的真实感评论家(realism critic),挂在冻结的 WavLM-large 编码器上。团队拿 6 个开源 TTS 系统和真人录音做盲测排序,还人为压缩停顿造出更细的质量阶梯;同时上了两道硬枷锁:一道是身份擦除损失,逼着裁判忘掉音频是哪个生成器吐出来的,杜绝指纹作弊;另一道是1.35 倍时长惩罚,只要生成音频超过参考音频长度的 1.35 倍就重罚,堵死慢速读字的路子。
这套组合拳最见功力的地方是跨语种泛化。第三阶段只喂了中英文提示词,却顺带把其余 13 种低资源语言的平均错误率从 22.53% 压到了 20.77%,音色相似度从 0.637 涨到 0.679。因为人类说话换气和停顿的物理节奏,在不同语言之间本来就是相通的。
越级跑分的背面:困难中文垫底与汉字 Token 污染
如果只看官方宣传的主表,Audio8-TTS-Realistic 简直是越级杀手。但把评测管线拆开对照就会发现,跑分优势很大程度上沾了统计口径的光。
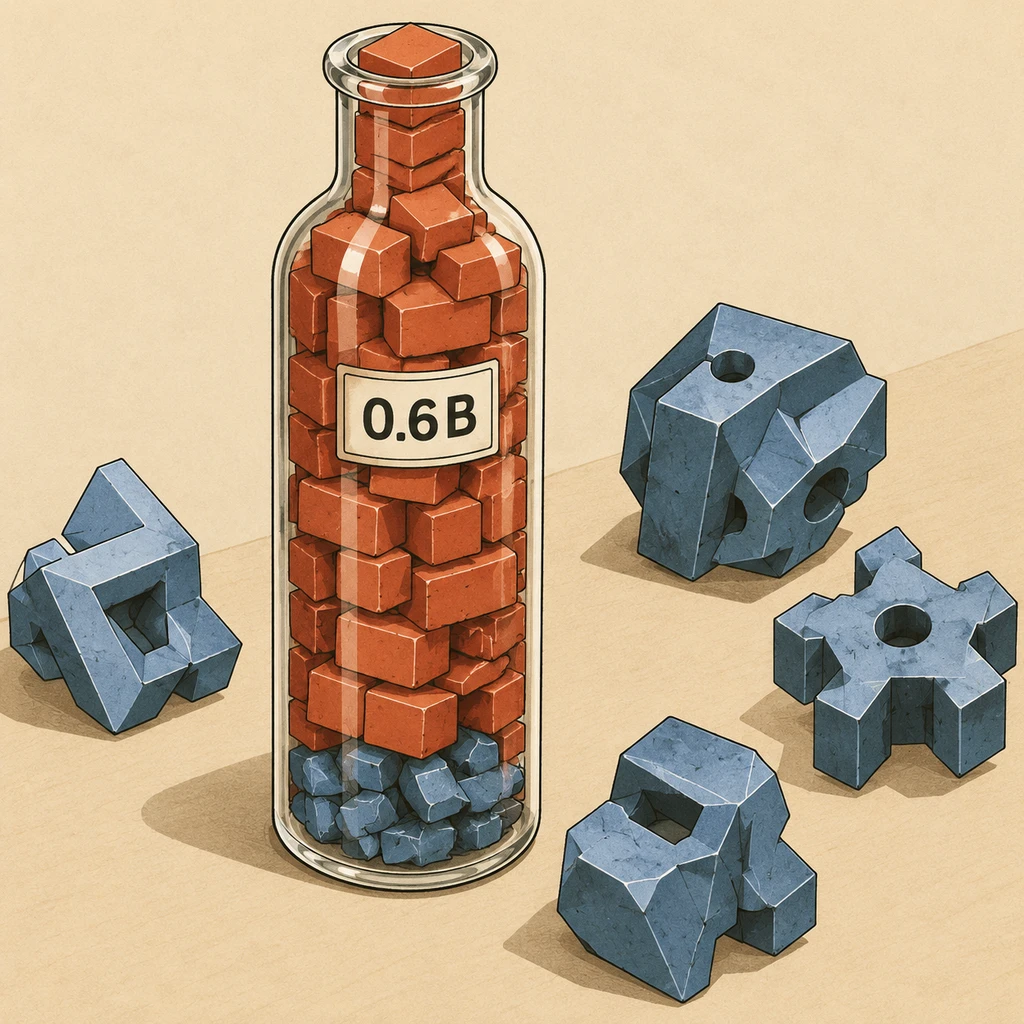
榜单赢在停顿节奏的跨语种泛化,输在汉字底座的容量天花板。
比如 Qwen3-TTS-1.7B 在 MiniMax 24 语言测试里跑出了难看的 27.41% 错误率,原因是这 24 种测试语言里有 14 种是 Qwen 官方压根不支持的语种;而 Fish S2 Pro 官方自测的 Seed-TTS 中英错误率原本是 0.54% 和 0.99%,到了 Audio8 团队手里,因为文本归一化(Text Normalization)标准不同,重测数据直接变成了 1.038% 和 1.607%。
更关键的信息藏在被主表排除的细分项里。宣传稿里 1.25% 的 Seed-TTS 中英平均错误率,其实剔除了专门考验生僻字、多音字和绕口令的困难中文(Hard Chinese)测试集。一旦把这个硬骨头端上来,0.6B 小底座的容量短板立刻暴露无遗:
| 模型名称 | 参数规模 | 常规中文 CER | 困难中文 CER | 中文音色相似度 (SIM) |
|---|---|---|---|---|
| Audio8-TTS-Realistic | 0.6B | 1.03% | 12.80% | 0.745 |
| CosyVoice3-1.5B | 1.5B | — | 5.83% | 0.781 |
| Qwen3-TTS-1.7B | 1.7B | 0.77% | 6.76% | 0.770 |
| VoxCPM2 | 2.0B | 0.97% | 8.13% | 0.795 |
在困难中文上,Audio8-TTS-Realistic 的字错率飙到了 12.797%,不仅远差于 1.5B 到 2B 的一众对手,甚至不如被重测拉低分数的 Fish S2 Pro(10.149%)。同时,在中英文音色相似度(SIM)上,它(英文 0.663 / 中文 0.745)也全面落后于 VoxCPM2、Qwen3-TTS 和 CosyVoice3。用小参数死磕韵律的代价,是声学表征的颗粒度和长尾字库记忆力打了折扣。
另一个重灾区是粤语。在 MiniMax 24 语言测试中,Audio8 的粤语字错率高达 31.35%,是全场唯一错误率破 20% 的语种(泰语在 CV3 上虽有 48.57% 的词错率,但在 MiniMax 字错率测试下为 6.674%,主要受泰文分词与评测集差异拖累)。粤语崩盘的病根在于汉字 Token 污染:训练数据里普通话占比极高,而粤语和普通话共享同一套汉字 Token,模型在 0.6B 的拥挤空间里,普通话的发音权重直接压倒了粤语,导致克隆粤语时频繁蹦出普通话读音。
端侧部署的误区与真实落地边界
很多开发者冲着报道里那句“苹果 M2 CPU 峰值内存仅 1.1 至 1.2 GiB”去下载模型,准备往端侧塞。这里必须澄清一个事实错位:1.1–1.2 GiB 的 INT4 ONNX 内存实测数据,完全来自前代模型 Audio8-TTS-Preview-0.6b。至于这次发布的 Realistic 版本,官方目前根本没有放出公开的 ONNX 导出文件,也没有确立最低内存和显存门槛。
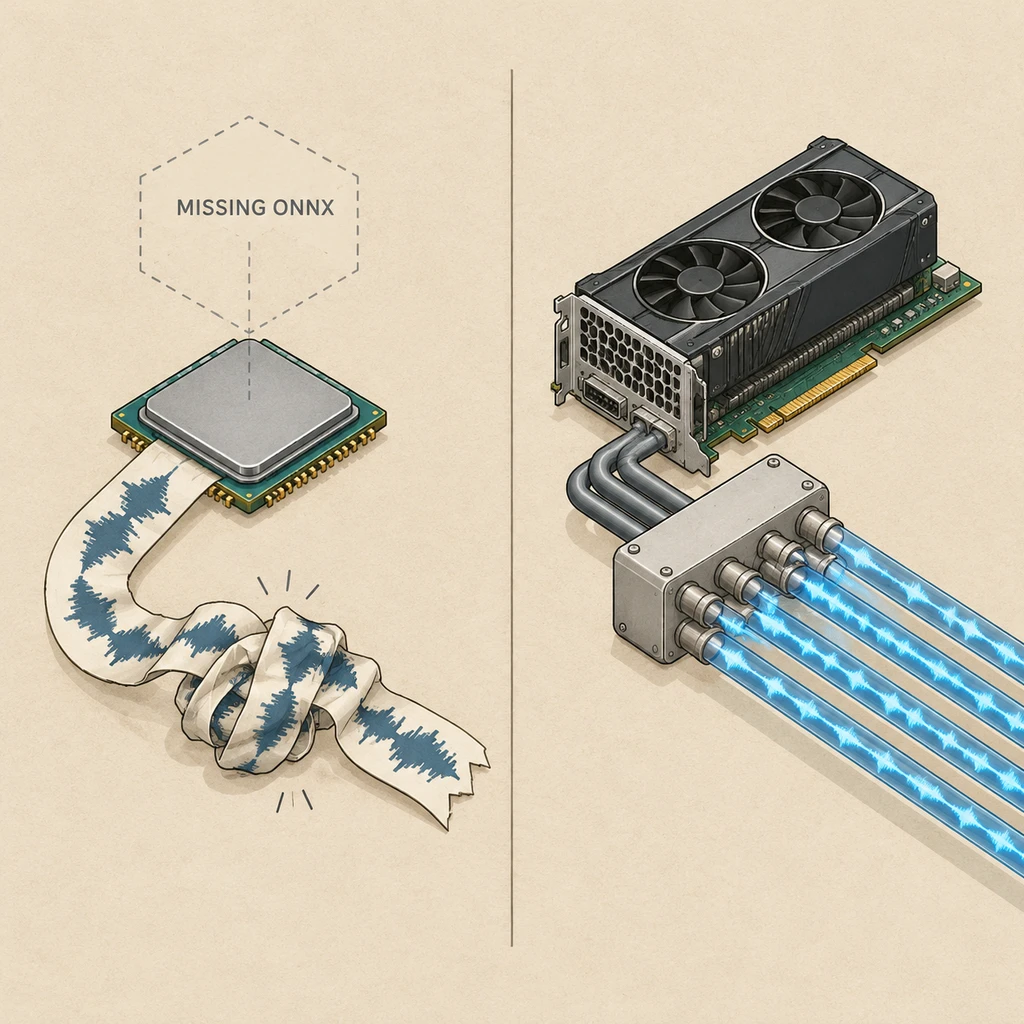
即便你自己动手参考前代脚本去转 ONNX INT4,也要小心社区已经踩过的坑。在 GitHub Issues(#38)中,已经有开发者反馈前代 ONNX INT4 路径在合成长段中文时,默认采样会出现早停截断,切成贪婪解码又会陷入死循环复读。
那论文里吹捧的真实感评论家到底带来了多少实质增益?对比前代 Preview 和新版 Realistic 的常规中英错误率,数字从 1.23% 变成 1.25%,基本原地踏步。作者在论文里也坦白了这名裁判的盲区:它只给相对排名,主要盯着停顿时间做文章,但对声学底噪、电流嗡嗡声(buzzing)和声码器伪影完全是个睁眼瞎。
- 风险.切勿直接将该模型用于粤语配音、泰语生产环境或包含大量生僻字的中文有声书项目,其底层 Token 冲突与小参数容量会导致高频错读;端侧 CPU 方案在官方解决 ONNX 导出与长文本早停 Bug 前不宜上生产。
那什么人现在最该用它?答案是手里有 GPU、需要低成本跑多语种常规对话的团队。Edge0 这次直接随仓库附带了 SGLang Omni 适配器,原生支持分页注意力(Paged Attention)、动态批处理,并暴露了兼容 OpenAI 格式的 /v1/audio/speech 接口。
在 1.5B 到 4B 的语音模型动辄吃掉大把显存的当下,一个 Apache 2.0 协议、601M 参数、能用 SGLang 轻松拉起高并发批处理,且把 20 多种外语的停顿节奏调教得像模像样的底座,依然是一笔划算的工程买卖。只是在按下部署键之前,你得清楚那 3M 参数的裁判只教会了它怎么像真人一样喘气,没替它背下新华字典里的生僻字。