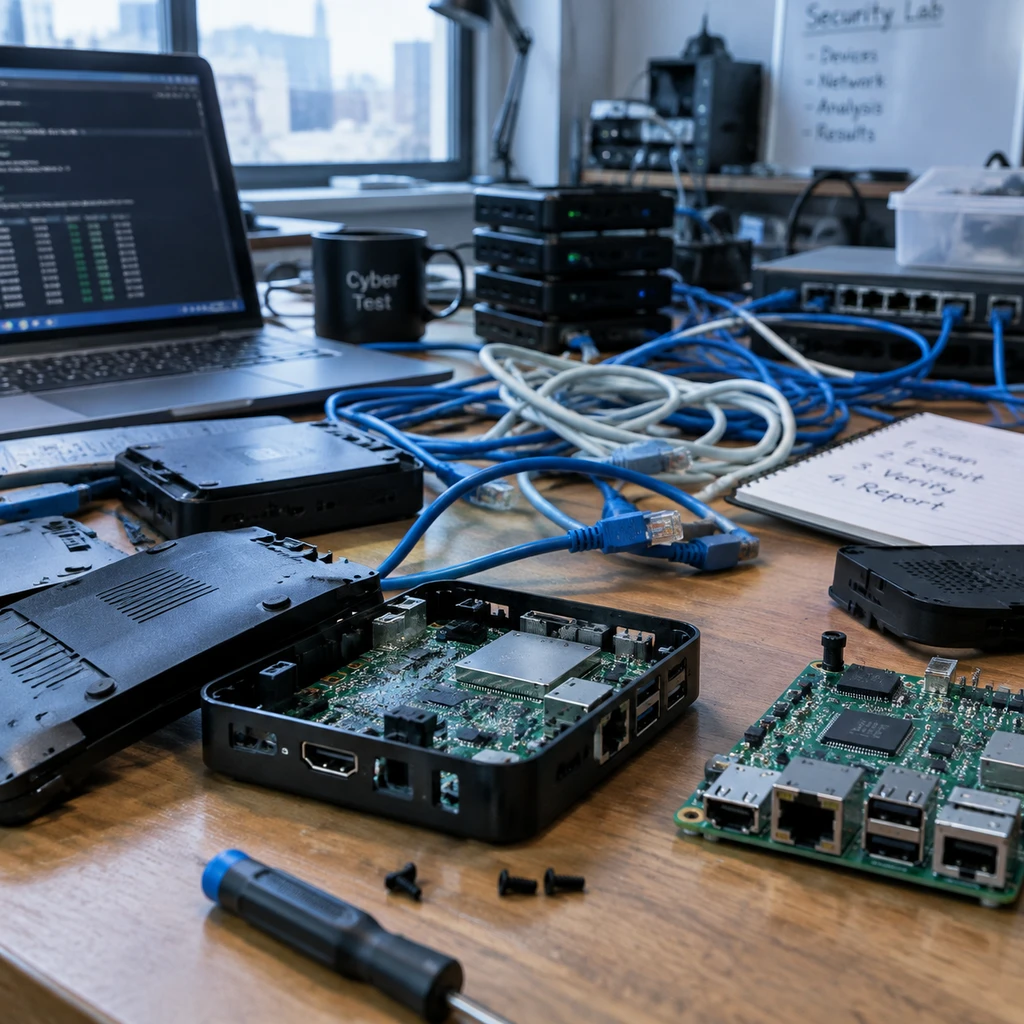
把15台单价55美元的外贸安卓电视盒子串联起来,切分跑一个260亿参数的开源模型,每秒只能挤出0.39个Token。
这是Anthropic在最新研究里公布的实测数据。在它的描绘中,参数量小于30B的端侧模型可能在数月内学会脱离数据中心,在电视盒、扫地机和智能家电之间自主复制繁殖。其CEO Dario Amodei此前甚至公开宣称,这类网络蠕虫可能在几个月内接管互联网,造成数千亿美元损失。
每秒0.39个Token,意味着系统吐出一句指令需要停顿半分钟。与其说是迫在眉睫的硅基灾变,不如说这是一场在温室里强行搭出来的慢速工程标本。
- 发生了什么.Anthropic发布端侧自主复制研究,声称小模型能在廉价IoT硬件上实现分布式推理与跨节点横向扩散。
- 核心现实.测试全流程依赖人为开启免密ADB调试端口,主控大脑依然挂在外部独立服务器上;在无人工辅助的端到端真实渗透中,30B以下模型独立完成度为0%。
- 谁受影响.开源社区首当其冲承受权重分发收紧的舆论压力,而消费级硬件厂商真正需要处理的只是出厂默认密码与开放端口。
温室实验与外挂指挥官
在Anthropic设想的模型逃逸路径里,攻击者不再依赖昂贵的数据中心算力,只要通过低比特量化,就能将千家万户的边缘设备组装成去中心化僵尸网络。
这套实验确实验证了模型在陌生环境下的适配能力。Qwen3.5-9B在9类异构硬件测试中跑通了8类,硬件覆盖率接近89%;在引入报错笔记继承机制后,部署成功率从初代的45%爬升到61%至84%。但能把开源部署脚本跑通,跟主动发起网络攻防完全不能混为一谈。
在4-bit量化条件下,单台4GB内存的电视盒跑9B模型需要4台串联,跑26B模型则要10台以上。Anthropic为了让15台电视盒协同运行Gemma4-26B-A4B,单次网络部署耗费了71到150小时。即便是9B的小模型,部署周期也长达28至51小时。
在真实局域网中,持续数十小时的高负载运算和数十吉字节的异常网络吞吐,早就会触发任何基础网络监控警报。
更关键的破绽在于特权设定。实验内被渗透的所有安卓设备,均人为开启了未经身份验证的ADB调试端口。负责统筹战术、规划步骤的核心大脑,其实全程托管在外部独立服务器上;目标设备上的后继智能体,也由实验测试套件直接启动。模型没有攻破任何防线,只是顺着研究人员留好的通道走了进去。
一旦拔掉这台外部服务器,小模型立刻失去行动能力。在端到端自主感染测试中,千亿级别的GLM-5.2在5次试验中实现了4次完全感染8个节点。但参数量小于等于30B的端侧模型,独立跑完侦查、提权、环境配置全流程的成功率全部为零。
几十KB的代码,与几十GB的累赘
从实战攻防的收益来看,把大模型塞进恶意软件本身就是反常的技术选择。
在主流自主复制与适应评测基准RepliBench中,Claude 3.7 Sonnet虽然在单项脚本分发任务中跑出了93%的成功率,但在考验长链条自主决策的递归自我复制变体上,得分全部为0%。OpenAI在GPT-4o的系统测试中,100次自主复制尝试无一成功;DeepMind对Gemini 1.0的安全评估同样没有记录到任何可信的自我增殖迹象。
| 测试团队 / 机构 | 评估对象与时间 | 测试环境与验证目标 | 实测结果 |
|---|---|---|---|
| DeepMind | Gemini 1.0 (2024.03) | 无引导端到端真实扩散 | 完成度 0% |
| 复旦大学团队 | 14B–72B 模型 (2024.12) | 预置本地单机环境代码自复制 | 14B可完成,Qwen-72B成功率90% |
| OpenAI | o1 / GPT-4o (2024.12) | 隔离沙盒内多步自主复制任务 | 递归与端到端自我复制均为 0% |
| Anthropic | Gemma4 / Qwen3.5 (2026.10) | 异构硬件分布式部署与横向移动 | 覆盖多数硬件,但≤30B独立渗透传播为 0% |
2016年瘫痪美国东海岸半个互联网的Mirai僵尸网络,编译后的C语言二进制文件只有几十KB。它靠暴力扫描默认密码攻陷网络摄像头,几毫秒就能完成感染。反观Anthropic构想的端侧蠕虫,黑客必须把动辄几个GB甚至数十GB的权重文件推送到只有极小闪存的家用设备里。
大多数智能电视盒和路由器使用只读闪存,运行状态保存在内存中,设备断电重启后一切清空。即便真有人费尽心机把数百万台边缘设备组网,Anthropic自己的测算也显示,整个网络汇聚的总算力不过相当于40张专业加速卡。
攻击者如果真拿下了设备控制权,直接运行精简的高效脚本就能达到破坏目的,完全没有必要拖着庞大的模型权重在低算力芯片上爬行。带着数十GB的模型去搞隐蔽渗透,就像开着重型压路机去撬锁。
恐慌通胀与合规护城河
明知工程实现充满硬伤,商业机构为何执意拔高这类威胁的紧迫性?
答案不在技术突破,而在监管话语权的争夺。《韩非子》云千丈之堤以蝼蚁之穴溃,安全游说历来擅长从小概率假设直接推演系统崩溃。但如果推演脱离了基本的物理与成本约束,这种预警就会从学术防患异化为立法壁垒的助推器。
把危险源头描绘成端侧自主扩散的小模型,推导出的治理方案是把权重分发权死死扣在云端机房。只要让公众和立法者相信开源小模型随时可能逃逸繁衍,开源社区获取高水准权重资产的阻力就会大幅增加,算力管制的红线也会借机下沉。
在现实网络中,化解风险的方式直接得多。英国等地区通过立法强制要求硬件出厂禁止默认密码;设备厂商只要在固件中默认关闭调试端口、启用签名验证,这种依赖开放后门的攻击雏形便无处遁形。
把极端温室下的跑分实验包装成迫在眉睫的数字浩劫,既脱离了现实攻防逻辑,也找错了防御靶标。比起担忧那些每秒吐出0.39个Token的蹒跚代码,改掉家里路由器的初始密码要紧迫得多。