人工智能资讯 第92页
聚合当前分类下的最新内容,按时间顺序查看第 92 页精选文章。
Hubble.md 上线:开源笔记想把 Markdown 文件真正让人和 AI 智能体共用
开源笔记应用 Hubble.md 把内容直接存成 Markdown 和 HTML 文件,界面对标 Notion 和 Apple Notes,卖点是人和 AI 智能体读写同一份文件。项目免费开源,GitHub 星标约 795,但官网没说清智能体接入协议、权限和同步机制。对已经用 Markdown 管理笔记的开发者,现在能试;涉及权限和隐私的生产场景,最好再等等。
60小时、10万美元:Claude的密码学发现,现实系统毫发无损
Anthropic披露,Claude Mythos Preview连续运行约60小时、估算耗费10万美元API费用,在HAWK签名方案和一个被削弱轮数的AES版本中找到数学弱点,但明确说明对现有系统没有实际影响。比漏洞本身更有信息量的,是研究人员反复催促模型别放弃、别挑容易目标的提示词原文,连拼写错误都保留了下来。这更像一份人机协作的操作记录,而不是自主科研能力的证明。
2.8万亿参数塞进64GB Mac:Deltafin让Kimi K3能跑,但离好用还很远
开源项目Deltafin让参数规模2.8T的Kimi K3在一台64GB内存的M1 Max Mac上跑了起来,靠的是把专家权重按需从磁盘或Hugging Face流式读入,而不是把整个模型塞进内存。但目前本地解码约15秒一个token,缺乏本地缓存时能拖到3分钟以上,还只支持贪心解码、单请求运行,这决定了它眼下更适合研究者验证MoE路由,还撑不起替代云端API的生产场景。
iOS新应用发布暴涨80%:AI没让App过时,只是让它变便宜了
2026年一季度,全球新应用发布量同比增长60%,iOS单独统计达80%。AI编程降低了做App的门槛,但没有降低做好App的门槛——稀缺的东西,从写代码变成了审美和克制。
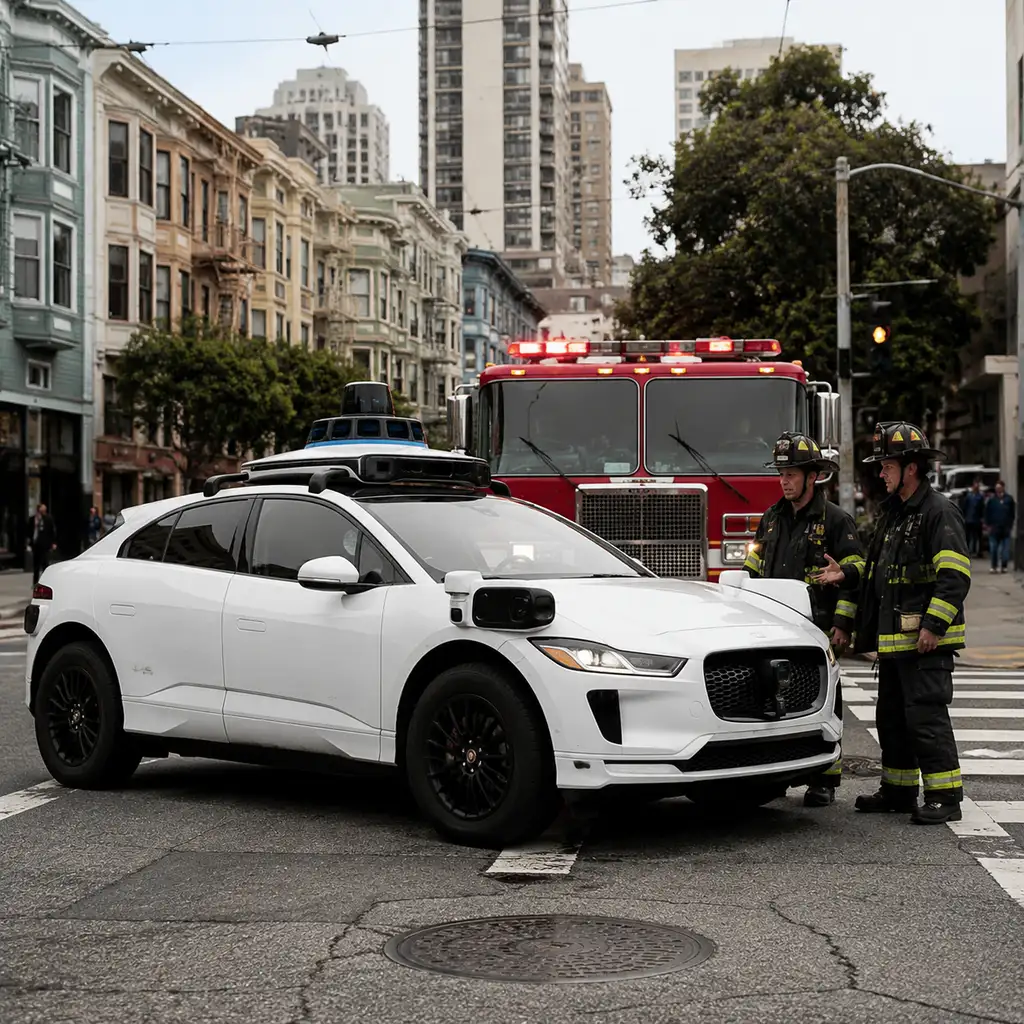
Waymo屡次挡住消防车,国会议员要给无人车装上'紧急开关'
加州众议员Kevin Mullin本周将提交《自动驾驶汽车应急响应协调法案》,拟让NHTSA制定全国应急响应标准,并允许地方政府在紧急状况下对Robotaxi实时地理围栏限行。这意味着监管思路正从企业自律转向联邦统一标准加地方实时干预,Waymo等运营商的城市运营自主权面临实质收紧,但法案能否在国会通过仍是未知数。
Kimi K3 把参数推到 2.8T,真正的考题是部署账单
Kimi K3 从 Kimi Linear 的 48B 扩展到 2.8T,并引入 LatentMoE、潜在注意力、全量 NoPE 和原生多模态。原作者称其为当前最大的开放权重模型,但总参数只是声量,激活参数、显存、吞吐和许可证才决定它能否真正部署。
4737小时压到30.5小时:Ai2的地球观测新平台,赢在工程不在模型参数
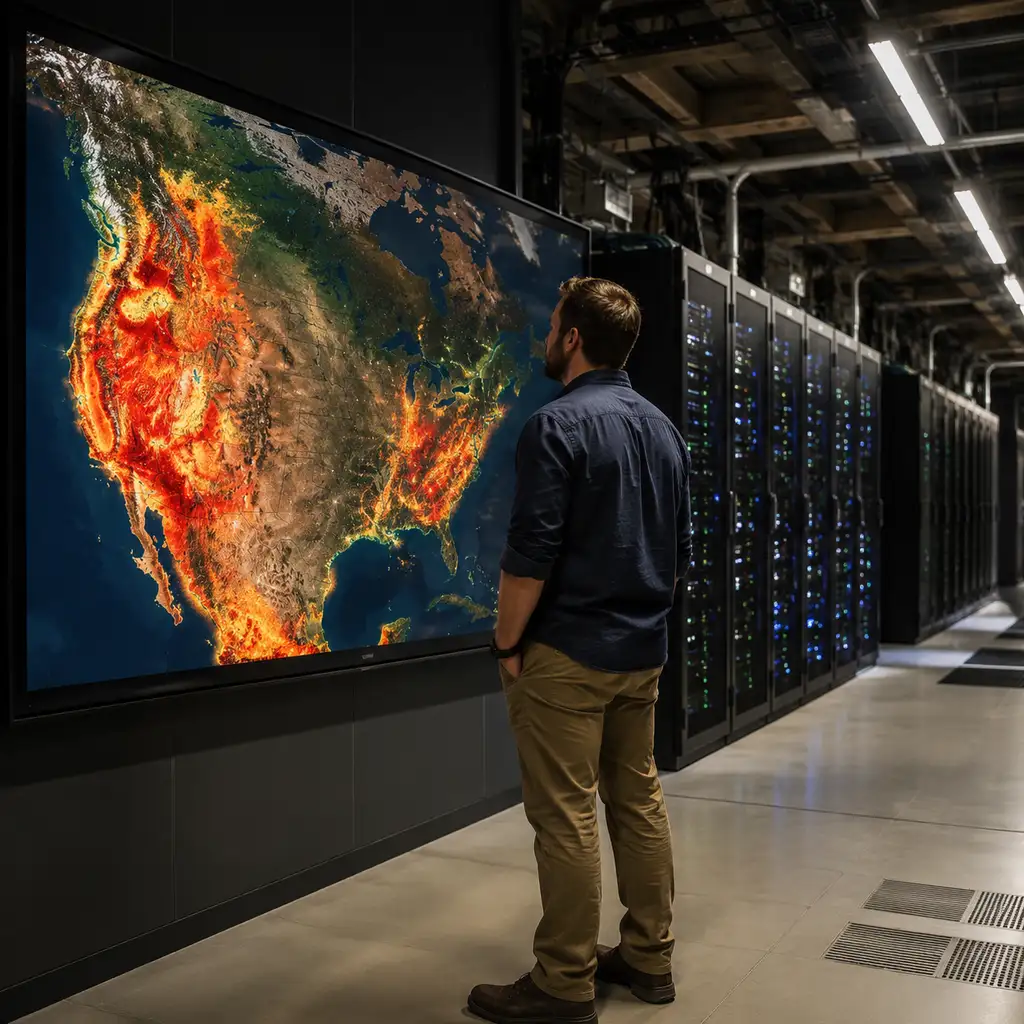
Ai2上线OlmoEarth Platform,把地球观测模型的微调、评估和洲际级推理打包成基础设施,官方案例显示北美野火风险制图从4737小时压缩到30.5小时,成本口径是每平方公里不到一美分。真正稀缺的不是模型参数,是能吃下上万核算力、扛住故障的工程系统——这恰好是缺工程师的政府和NGO最需要也最用不起的部分。目前只有Ai2一家口径,还没有第三方复核或其他区域案例。
Kimi Delta Attention是怎么来的:遗忘门被拆到了每个key通道
Doubleword技术长文推导了Kimi等模型使用的线性注意力机制KDA,核心是把统一遗忘门拆成按key通道独立衰减的对角矩阵。真正价值是把长上下文记忆管理变成可逐层复现的工程设计。原文没给出性能或成本数据,研发团队仍需自己跑基准测试再决定是否迁移。
Substack给文章打AI分,创作者喊话“这是猎巫”
Substack给每篇文章打上AI生成概率评分,创作者却炸了锅,担心一次误判就毁掉多年积累的口碑。平台强调评分不进推荐算法、可关闭可申诉,但当一个概率猜测被公开挂成标签,举证责任已经悄悄转移到了作者身上。比起打分,那句可选填的“How I make this”声明,可能才是建立读者信任更靠谱的办法。
3.7倍提速的代价:Liquid AI新编码器只在CPU长文本上占优
Liquid AI于7月28日发布LFM2.5-Encoder-230M和350M两款编码器模型,均支持8192 Token上下文,官方自测显示230M版本在CPU长文本推理上比ModernBERT-base快约3.7倍。这类模型解决的不是对话能力,而是企业高频的分类、路由、抽取任务能否继续用现有CPU跑得更便宜;速度优势集中在长输入和CPU场景,短文本和GPU场景ModernBERT-base仍有领先,基础模型也仍需按任务微调才能上线。
Kimi Linear:省75%缓存、6倍吞吐,线性注意力这次敢跟全注意力拼效果了
月之暗面发布 Kimi Linear,一个逐层混合 KDA 线性注意力与 MLA 全注意力的 MoE 模型,激活参数 3B、总参数 48B。官方数据显示,同训练方案下它全面优于全 MLA 基线,百万上下文最高省 75% KV Cache、解码吞吐最高提到 6 倍。这些都是论文自报的最高值,对比基准是自家训的模型,还没有外部团队独立复现。
苹果iMessage敏感内容警告把宠物狗视频误判为裸露内容
苹果iMessage的敏感内容警告把一段宠物狗视频误判为疑似裸露内容并自动打码,2024年鹿照片、2025年狗照片也曾触发同类误报。苹果称识别在设备端完成,不会读取或留存消息内容,问题出在识别精度而非隐私边界。功能可在设置中关闭,但对依赖它拦截非自愿裸照的用户和家庭来说,误报越多,这道防线被弃用的风险越大。
Recursive Superintelligence签4亿美元AWS算力协议,亚马逊只卖算力不买股权
AI初创公司Recursive Superintelligence今年7月与AWS签下一份多年期算力协议,官方口径约4亿美元,相当于其5月披露的6.5亿美元融资的六成以上。跟OpenAI-微软、Anthropic-亚马逊常见的投资加算力捆绑不同,这次AWS只卖资源,不买股份。10月前后能不能拿出可用产品,才是检验这笔钱花得值不值的第一个节点。
开源攒下800万用户,Fish Audio现在靠闭源模型赚钱
Fish Audio完成5000万美元种子轮,公司称已有800万用户和2100万美元ARR;开源模型攒起社区,最新旗舰S2.1 Pro转向付费API。声音未经同意被使用的争议还没过去,这暴露出企业采购前必须核实的授权缺口。
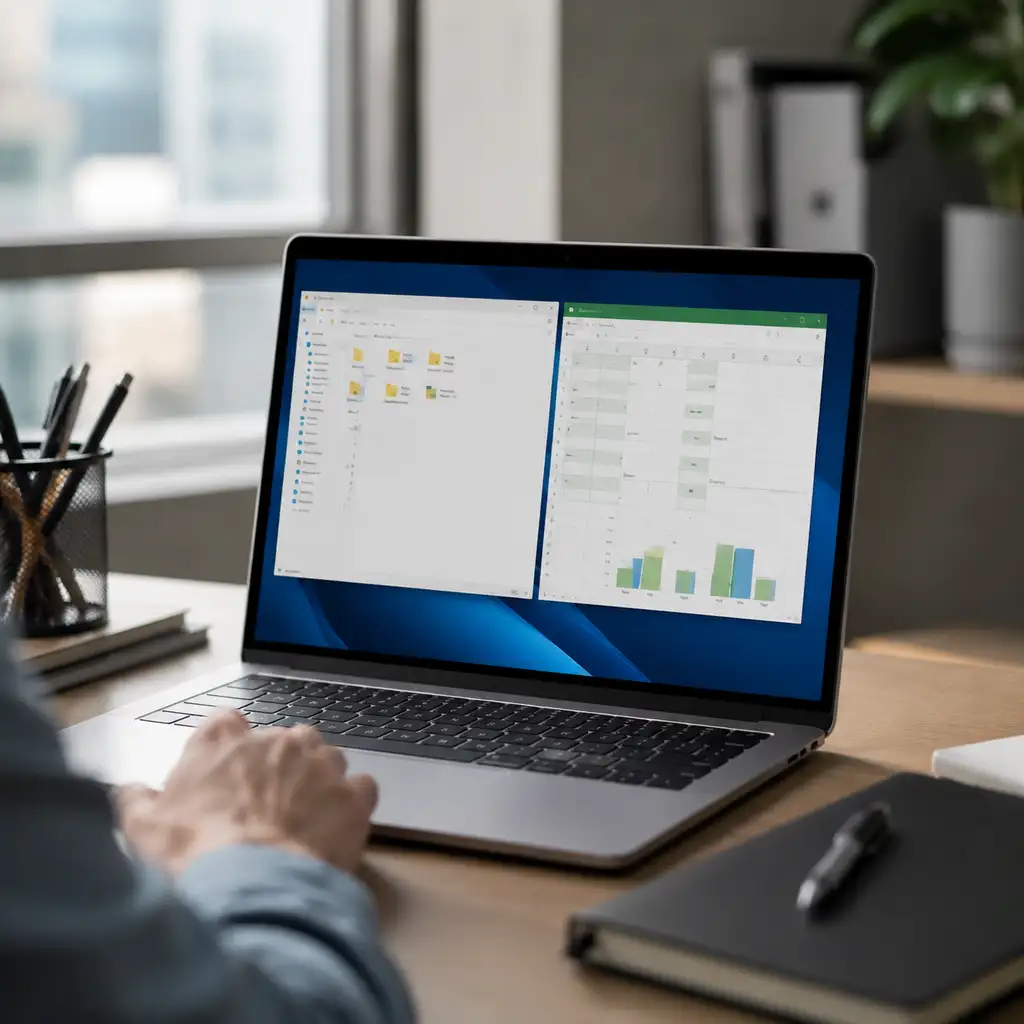
200美元一个月:Perplexity让AI在你的Windows电脑上动手干活
Perplexity把原本只跑在Mac上的Personal Computer搬到Windows,月费200美元起,面向Max和Enterprise Max用户。这次的关键不是又添一个AI助手,而是AI第一次拿到操作本地文件、Windows应用和Office文档的权限。企业该判断的不是好不好用,而是权限出错时谁来兜底。
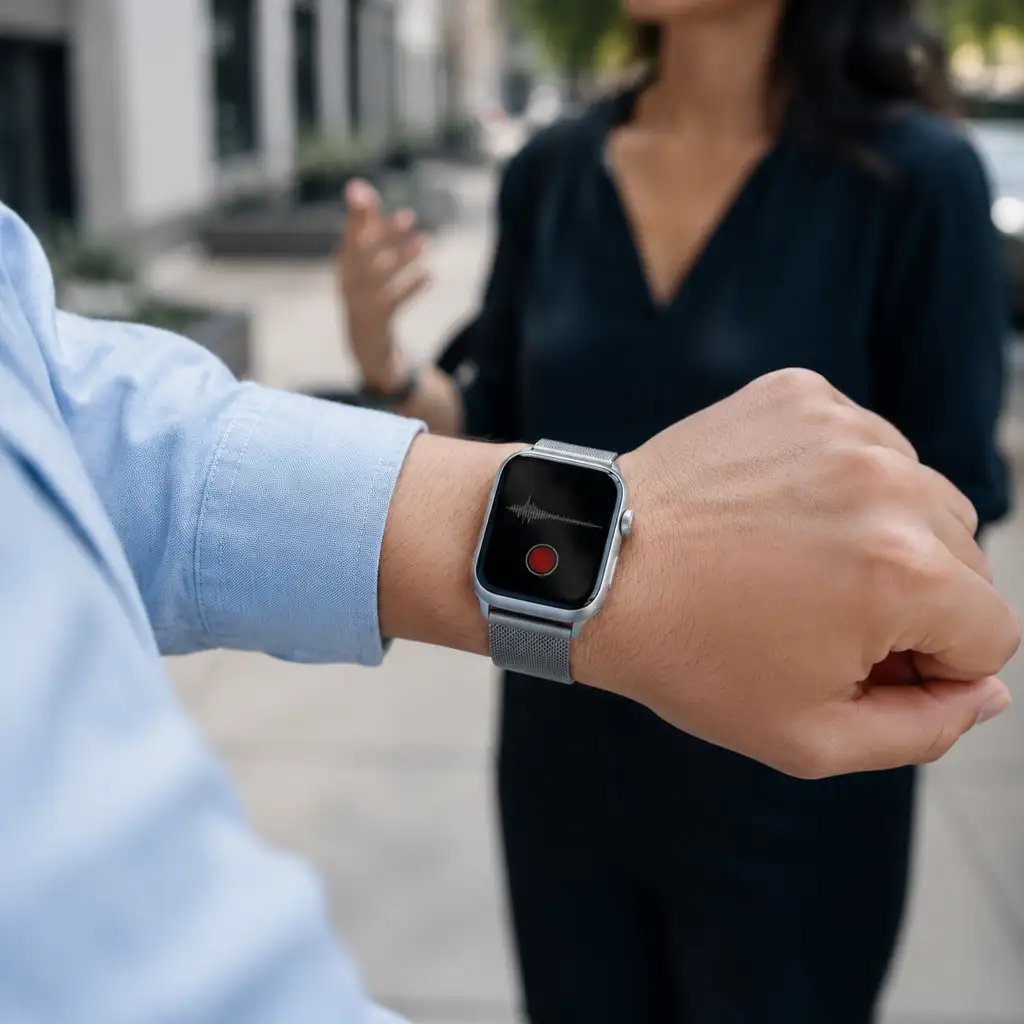
Granola 上线 Apple Watch 应用:抬手腕录会议,不用掏手机
Granola 推出 Apple Watch 应用,可直接从表盘启动转写,并与去年上线的 iOS App 数据打通。目标场景是走路一对一等不便掏手机的线下会议,公司称内测阶段部分员工的移动端使用已转向手表。摩擦是降了,但续航、录音告知和隐私边界还没答案。
AI硬件都在拼酷炫,这枚戒指赌的是省掉掏手机那一步
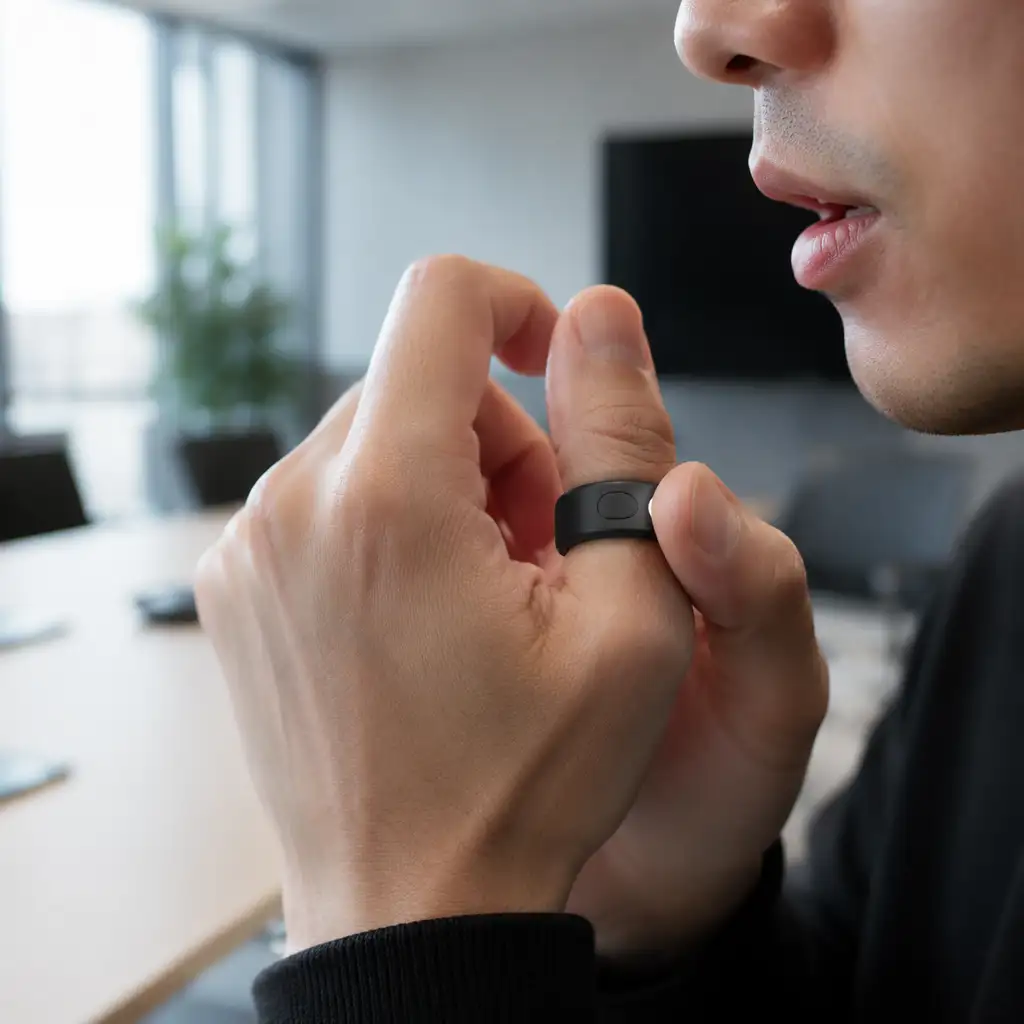
Sandbar计划年内发货智能戒指Stream,按住触控板、低声说话就能把语音转成文字输入到任意设备。它比听写软件、智能眼镜、AI别针都省步骤,赌的是少动一步。但产品还没发货,准确率、隐私机制和公共场合可用性目前都是问号。
百度机器人出租车进伦敦,Lyft争的是牌照不是车
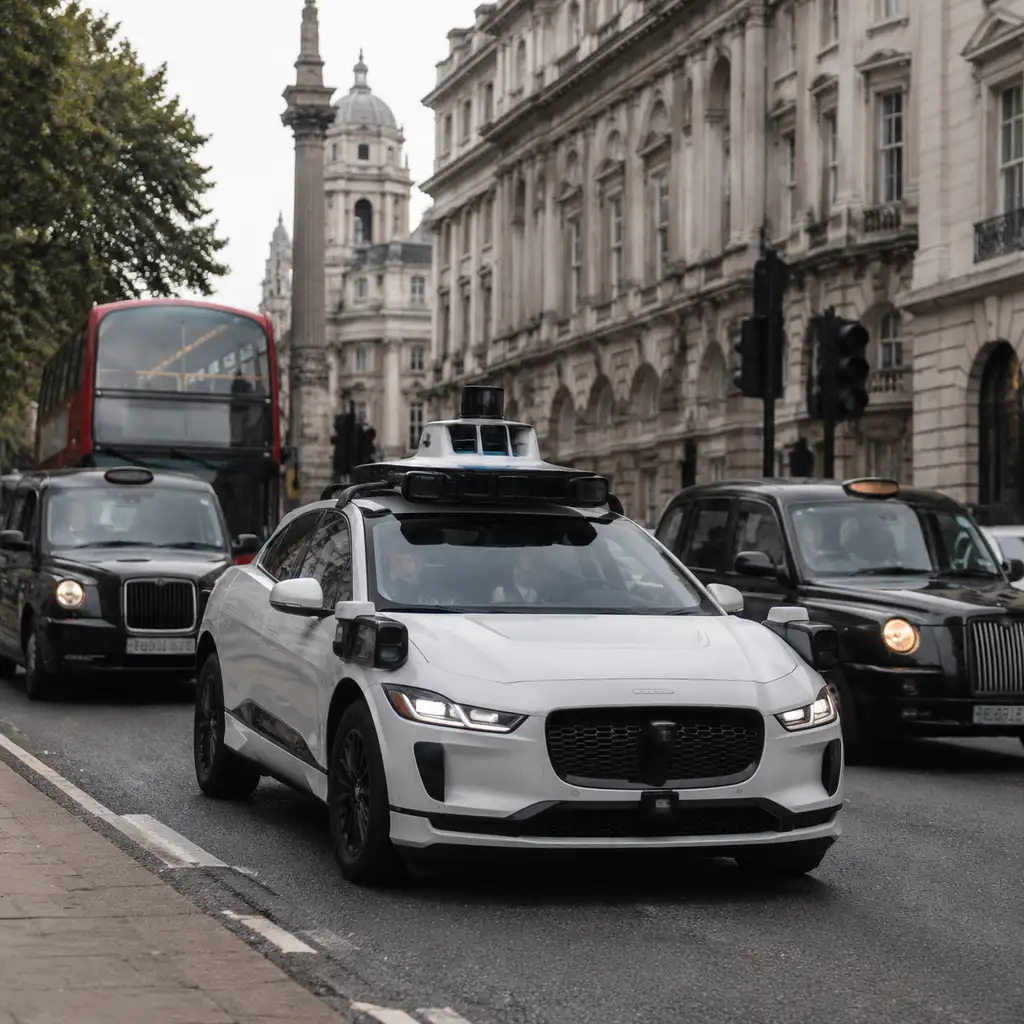
百度Apollo Go RT6于7月起在伦敦布伦特区带安全员测试,目标2027年经Lyft旗下Freenow向公众开放叫车。Lyft靠2025年约1.97亿美元收购的Freenow拿到欧洲入口,百度补上自动驾驶技术,各取所需。伦敦同期还有Waymo、Uber联手Wayve在跑,真正的卡点是英国监管审批节奏,不是谁先把车开上街。
8B模型压成3.88GB,一份文件喂进数据中心、游戏显卡和苹果芯片
Fermion Research 用专有三值格式把 Qwen3-8B 压成 3.88GB 单文件,称同一文件能在数据中心 GPU、8GB 显卡和苹果芯片上直接跑。速度、跑分和推测解码数据均来自厂商模型卡,没有第三方复测,也没跟常见 GGUF/AWQ/GPTQ 版本对比。权重协议是 Apache-2.0,但真正卡住迁移的是专有格式和自维护的 llama.cpp 分叉。
500美元微调的9B模型,审核任务上跑赢了前沿大模型
FermiSense用大约500美元对一个9B开源模型做强化学习微调,在同一套电商目录审核流程里拿到87.3分,超过测试过的所有前沿模型(最高76.9分)。这个专用模型推理成本只有每千条0.5美元,比最便宜的前沿方案还低约40倍。真正决定胜负的不是参数大小,是谁把稳定流程和专有数据攒成了自己的模型。
5分钟接入开源模型:松开的是订阅锁,不是机房锁
一位常年用Claude、ChatGPT写代码的开发者,因套餐额度不够,花5分钟把opencode接上了自己在Modal部署的Kimi K3端点。轻松感来自少绕过产品层,不是模型跑分意义上的胜出。作者是Modal员工,他把对Anthropic、OpenAI的依赖换成了对Modal的依赖,这条路谁该现在走、谁该再等等,原文给出的证据还不够充分。