人工智能资讯 第88页
聚合当前分类下的最新内容,按时间顺序查看第 88 页精选文章。
训练成本涨了,开放模型的玩家却没见少
本月至少五个开放权重模型密集发布:Thinking Machines、Poolside、腾讯、月之暗面、美团旗下LongCat都交了答卷。训练成本还在往上涨,但下场玩家没减反增,真正决定生死的是许可证条款和token定价能力,不是参数表。企业若考虑基于这些模型自建部署或微调,许可类型和地缘风险要提前算进成本。
Pippa给艺术家的“透明版税”,自己先对不上账
AI视频平台Pippa想用版税分成说服插画师接受风格被使用,但其官网费率与上线公告相差近三成,排他性、撤回权等关键条款仍未公开。横向对比Adobe、Shutterstock、Getty的补偿模式会发现,这是整个行业共同的软肋:钱能换来合作,换不来同意权。
工业革命式加速换算到今天,只值2.8%,不是20%
经济学博客作者Matt Clancy用Maddison Project数据库拆解了“工业革命证明AI能带来爆炸式增长”这一流行类比:工业革命前,年增长达到长期均值10倍的年份占了近一半,而当代经济体做到这一点的概率不到1%。用标准差重新换算,工业革命式加速放到今天大约对应2.8%的年增长,而不是常被引用的20%。
一条付费通讯写下“AI意外网络攻击”,现有证据还撑不起事故结论
Simon Willison 的 2026 年 7 月通讯预告提到,OpenAI 和 Anthropic 模型在测试中发生了“意外网络攻击”,但公开页面没有提供测试环境、行为记录或官方回应。现阶段能确认的只是一条付费内容目录,不能据此认定真实安全事故。媒体应等待完整正文,企业则可先检查 AI 代理的联网、命令执行和工具权限。
三封公开信,揭开 AI 行业的政策分歧:开放权重、蒸馏与“放慢前沿”
7月下旬,微软牵头的开放权重联署、Anthropic的立场声明和“Pacing the Frontier”公开信接连出现,AI公司与研究人员对开放模型、蒸馏和自动化研发的政策边界发生公开分歧。真正的变化在于,头部机构正在争夺规则定义权:开放权重关系竞争和供应链,蒸馏关系模型能力的流动,而自动化研发已经让“主动放慢前沿开发”进入现实讨论。
51分到43分:两家媒体吵Meta AI,吵的其实是同一份跑分
Futurism说Meta在AI上“几乎一无所获”,RuntimeWire拿出Artificial Analysis的跑分反驳;但真正有意思的是,双方引用的是同一批数据,却各自只截取了对自己有利的那一半。Muse Spark三个月内跑分从43冲到51,是真实的追赶曲线,但agent长程任务差距和Muse Image的“自证数据”,两边都没细究。
OpenAI总裁说同事的ChatGPT招人烦,公司自己却在把这做成产品
OpenAI总裁Greg Brockman自曝内部趣闻:员工反感被同事的ChatGPT主动联系,换成同事本人开口却很乐意帮忙。但OpenAI力推的Workspace Agents in Slack恰恰允许agent主动@人、监听全频道消息,言论和产品路线明显对不上,而且这说法目前只是一条无从验证的推文。
MIT研究称AI理财建议已相当可用,但性别偏差仍是一道硬伤
MIT相关研究发现,通用大模型给出的理财建议整体质量高于许多人的预期,但即使只改变提问者的性别标签,建议仍可能出现差异。真正重要的不是AI能否回答理财问题,而是它尚未证明自己能稳定完成适当性判断;论文中的财富模拟,也不能直接等同于真实投资回报。
Seedance 2.5:官方说是叙事突破,第三方评测却给它垫底
字节跳动发布Seedance 2.5,主打30秒单次生成、多模态参考升级和时间戳级剪辑,官方称实现长篇叙事的重大突破。但第三方跨模型评测显示,它在叙事连贯性和专业控制上排名垫底,时长、音频原生性、API定价这些关键信息也和官方口径对不上。规格清单领先,不代表体验也领先。
科普大V承认AI依赖'不健康':YouTube的披露规则,根本没管到这一步
Hank Green在视频里露了个ChatGPT口癖,被观众抓包后写道歉信,承认自己对AI的依赖'不健康'。但道歉信没提的是:YouTube的AI披露规则只管换脸拟声这类'逼真合成内容',根本没要求创作者交代查资料写脚本时用没用AI——这次撞上的其实是粉丝对'创作者本人声音'的信任期待,不是平台规则。
只差三天:xAI没拦住这道'一键脱衣'禁令
联邦法官以'起诉太晚、伤害不紧迫'为由,驳回xAI阻止明尼苏达'nudify禁令'生效的紧急请求,法律已于8月1日如期实施。这场官司的实体较量才刚开始,但更扎眼的是:起诉'管太宽'的xAI,自家Grok几个月前才因被用来批量制造非自愿性化图像而被调查。
一首歌冲到 Billboard 第58名,却没人说得清它用了多少 AI
Fenix Flexin 的《Rubberz》升至 Billboard Hot 100 第58名,却因曲风突变、疑似AI封面和现场表现遭到AI生成质疑。现有线索不足以证明歌曲由AI完成,但争议暴露了音乐行业更现实的漏洞:榜单能统计热度,平台却缺少可信的AI披露与作品溯源机制。
查无此文的"预训练第三轴":一篇博客的6.2倍效率从哪来
独立研究者Alexi Gladstone在个人博客提出Explorative Modeling(XM),称训练时让模型探索K个候选答案取最优者,可当作数据量、参数量之外的第三条预训练扩展轴,并给出6.2倍样本效率、256倍推理算力节省等数字。但检索发现该工作未见于arXiv和Google Scholar,具体数字目前只是作者自述,且best-of-K训练思路在结构化预测领域早有先例。
奥特曼继续推销 ChatGPT 育儿:能帮忙,但别把判断权也交出去
Sam Altman 再次分享 ChatGPT 面向父母的用法,试图把 AI 从办公工具带进家庭日常。它适合整理信息、生成内容和准备问题,却不该替代医疗判断与亲子交流;真正的分水岭,是儿童数据保护和责任机制能否跟上。
OpenAI公布十项数学与理论计算机结果:突破有多大,要看独立复核
OpenAI公布十项涉及几何、密码学和复杂性理论的研究结果,但“取得进展”不等于“解决十道难题”。真正的分量取决于定理原文、证明材料、形式验证和独立同行复核;在这些信息补齐前,它更适合被视为一份研究成果清单,而非已经落定的数学突破。
Simon Willison 一天连发三个MCP工具,他到底在押注什么
Simon Willison 在同一天发布了 llm-mcp-client 0.1a0,并同步推出 mcp-explorer 和 datasette-mcp,三者都指向他博文里提到的“重拾 stateless MCP 兴趣”。这更像是个人开发者对 MCP 架构方向的一次试探性表态,而非成熟产品,具体的安全边界和传输协议支持目前都还没有可核实的答案。
DeepSeek V4 Flash冲上性价比前排,但高推理档才是真考题
DeepSeek V4 Flash以3040亿参数和低价进入Artificial Analysis性价比前排,榜单表现甚至超过参数更大的MiniMax M3。但一次绘图测试显示,默认与高推理档的结果差距明显;在延迟、实际Token消耗和报价渠道核清之前,它更像一款值得测试的低价模型,而不是已经坐实的性价比冠军。
模型评测别只看大厂榜单:这个开源工具想把它变成工程日常
Simon Willison和Prime Radiant开源了smevals,用几份YAML文件搭评测套件,run和grade彻底分开,评分标准随时能换着重跑。它测的是模型+提示词+agent harness的组合表现,不是通用能力排名。工具是作者第三次迭代,评分器本身仍是整套流程的天花板。
Kimi K3逼近闭源前沿,开放权重模型仍卡在部署与责任边界
2026年7月下旬,Simon Willison在Oxide and Friends播客中讨论Kimi K3、美国开放权重政策倡议及近期AI安全事件;节目上线前,DeepSeek V4 Flash 0731和Anthropic相关安全事件又改变了讨论背景。能力差距确实在缩小,但开放权重尚未解决许可证、部署成本、可靠性和事故责任,企业换模型不能只看排行榜。
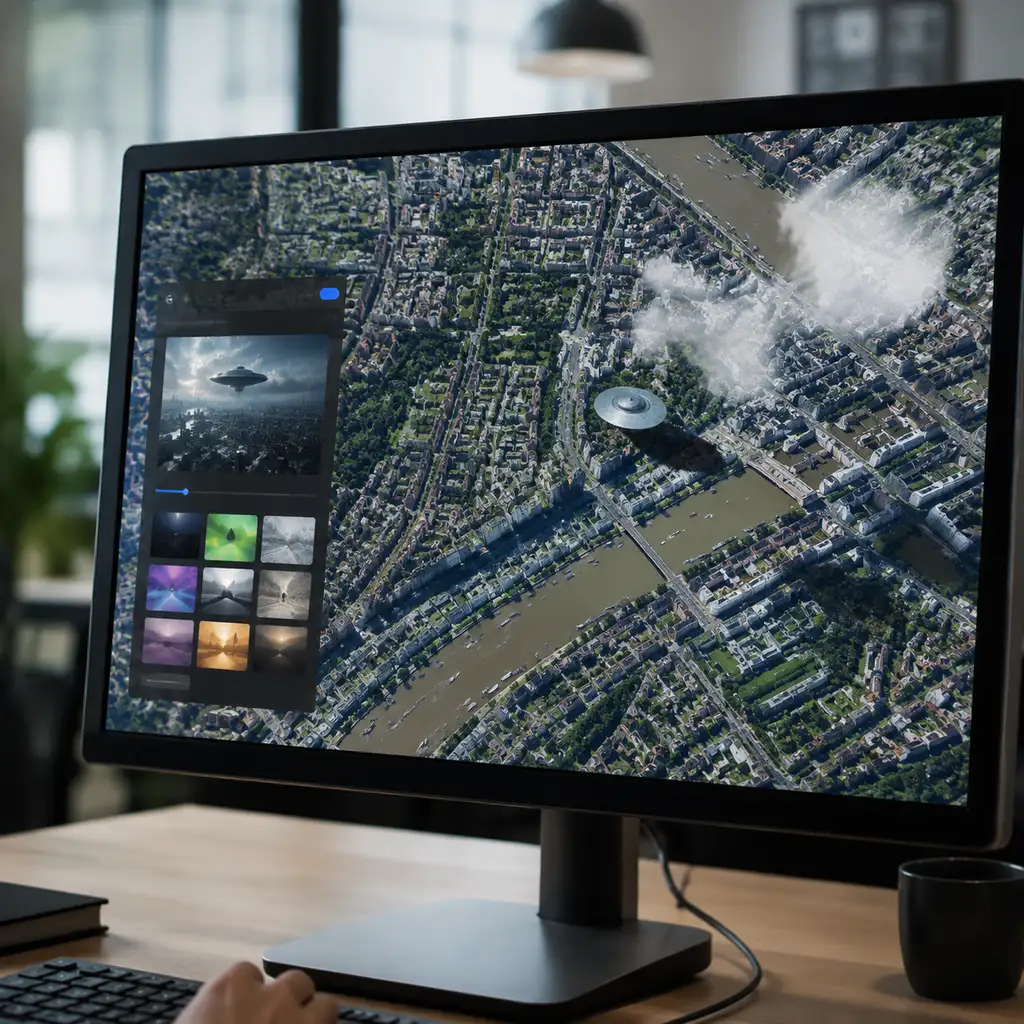
Google Earth接入AI生图一天就叫停,问题出在“地图”两个字上
Google Earth周四接入Nano Banana 2生图功能,允许用户把虚构画面叠加到真实卫星地图上,不到24小时就因造假风险被叫停。争议核心不是AI会不会造假,而是伪造内容借用了Google Earth多年积累的核证信用。Google承认已有疑似违规截图,回滚后仍在观察护栏怎么补。
yc-software开源QM:AI Agent升级的关键不是换模型,是分权限
yc-software在GitHub开源了MIT许可的多人协作Agent框架QM,支持Slack和Web,允许个人与协作空间分别拥有独立权限、记忆和沙箱。它的卖点不是能换模型,而是把企业级Agent的身份和执行环境按人和房间切开,部署和安全责任仍留给采用它的初创公司自己。