人工智能资讯 第63页
聚合当前分类下的最新内容,按时间顺序查看第 63 页精选文章。
AI审核AI临床笔记:查得出乱写,查不出漏写
一份新预印本用500组笔记构建的OmissionBench基准显示,负责审核AI临床笔记的LLM评审模型,能可靠识别“多写、错写”,却几乎查不出“漏写”,判别力接近随机猜测。配套的真实世界普查更扎心:同一批笔记换一套审核指令,验证出的错误比例能从9.3%飙到79%,说明行业现在拿出来的AI笔记错误率数字,脱离审核方法谈都不完整。
18万行代码写完了,审查却卡住了:Claude替WINE重写了Direct2D
Paint.NET作者Rick Brewster让Claude从零逆向重写了一套Direct2D替代实现,约18万行代码,专供WINE环境下的Paint.NET使用,通过/wine参数触发。作者坦言这些代码基本没被认真审查过,是典型的“vibe coded”,这恰恰说明AI编程真正的瓶颈已经从能不能写,变成了谁来审、谁担责。
Datasette的MCP插件转正,一个数据结构改动救了谁的命
Simon Willison发布datasette-mcp 0.2,首个正式版把execute_sql返回的行数据从数组的数组改成对象数组,专门解决弱模型对不上列名的老毛病。这次改动不大,但暴露出AI agent接数据库这件事,工程重心正从“能跑通”转向“迁就模型弱点、补上权限漏洞”。
神经网络里到底藏没藏着符号结构?一篇新论文只敢说"接近"
8月30日提交arXiv的论文(编号2608.29530)显示,把神经网络的向量表征换成符号结构闭式方程,模型行为基本不变;对LLM内部表征做定向干预,还能按预期改变输出。这提供了一条连接连续向量和符号结构的实验路径,但离证明神经网络本质是符号系统还差得远。
LLM推理的“效率前沿”:一套人人在讲、谁都没验证的说法
Baseten用“效率前沿”把batch sizing、并行策略、量化、推测解码等推理优化手段分成两类,还甩出KV路由带来2倍TTFT提速的案例;但这套框架缺可复现基准,Google Cloud几乎同期发布了同类文章,说明这更像行业通用话术而非独家洞见。
AI帮你画了条社区边界线,但这条线可能压根不存在
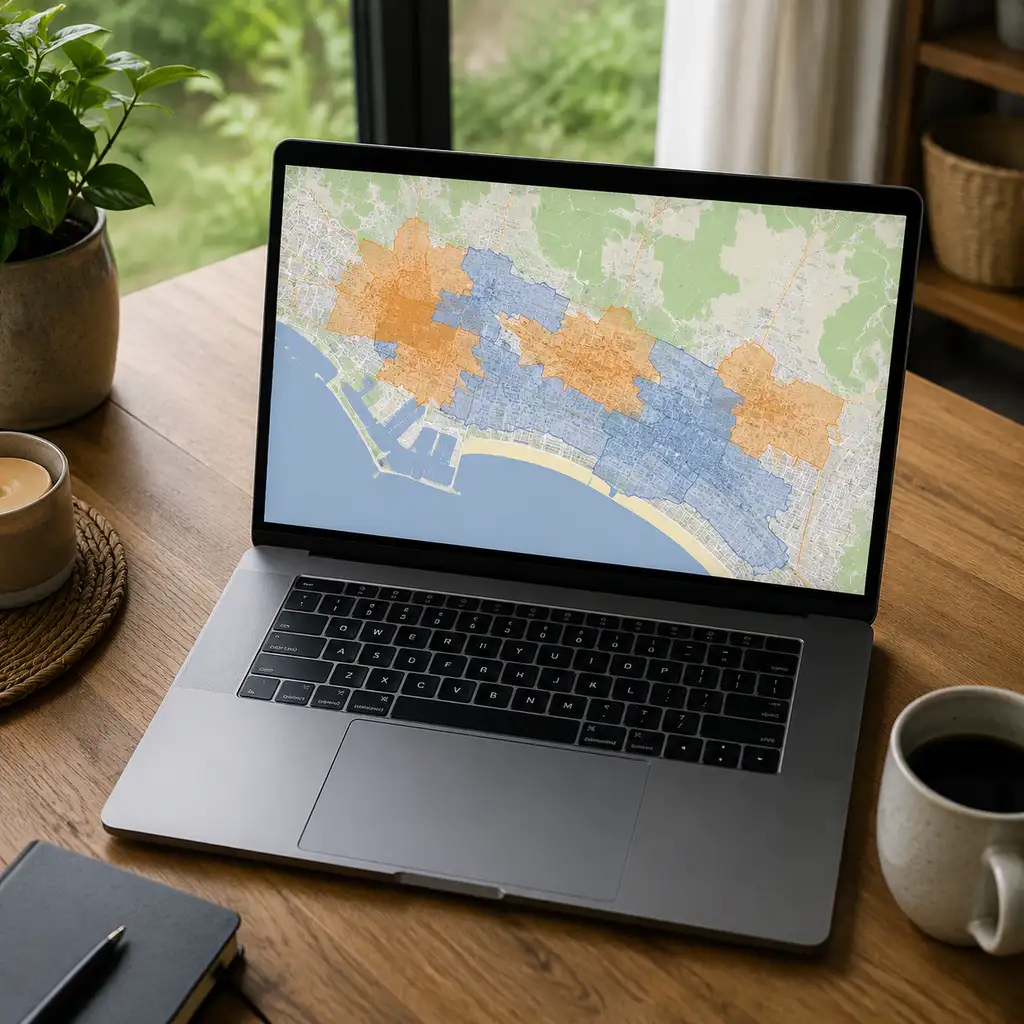
Simon Willison用GPT-5.6-Sol、Claude Code、Fable三个AI接力做出一个GeoJSON地图查看导出工具,又用ChatGPT从政府数据源拼出社区边界数据。工具本身是扎实的工程活,但拼出来的边界未必有法定几何依据,咨询性社区委员会的'边界'很可能只是AI对社区名称的推断。
10美分到3.3美元:Claude Fable 5.1的骷鹕测试,拆出三处水分
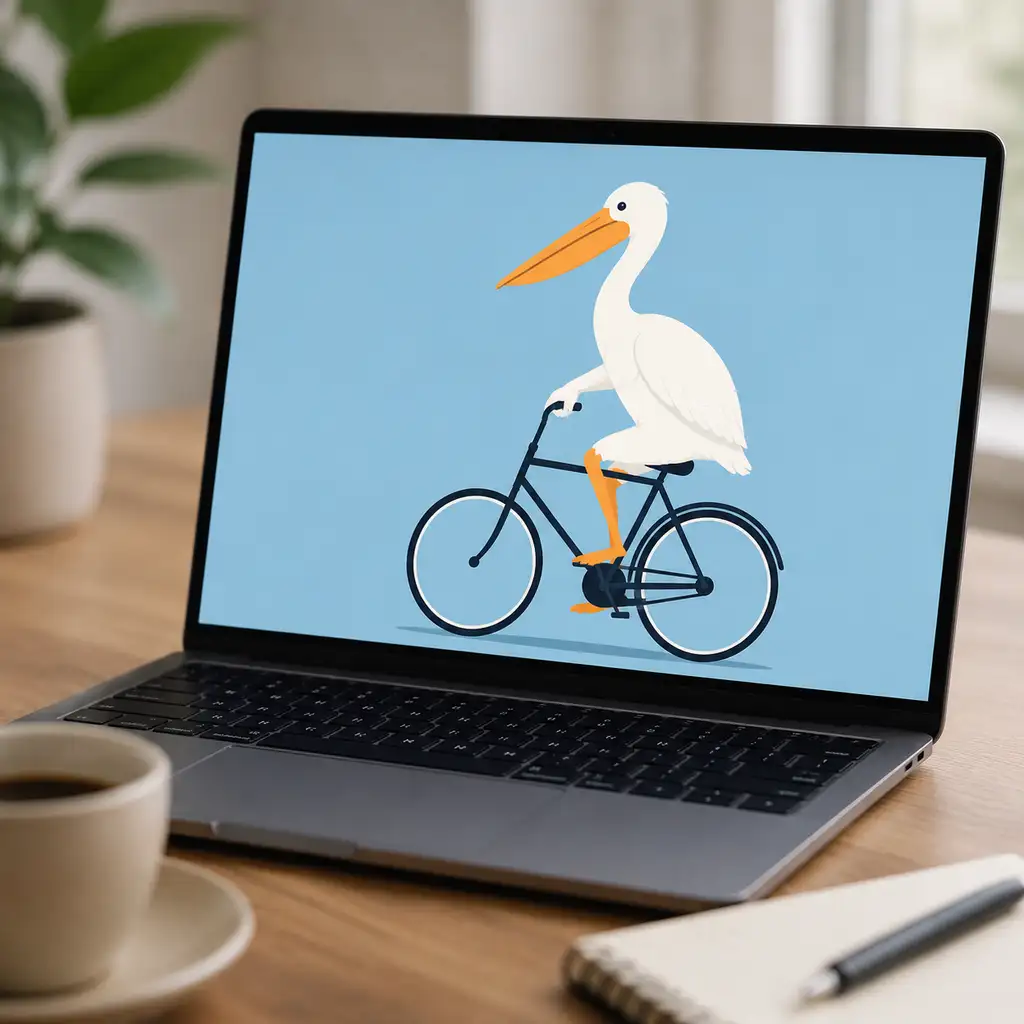
Simon Willison用同一句提示词测试Claude Fable 5.1的五档推理强度,价格从10美分跳到3.30美元,画质提升却极不均匀,低档位甚至没启动推理。同一天Anthropic自报的52.6%科研基准分数,和这个基准公开榜的历史数据也对不上。骷鹕测试还能不能当真,和跑分能不能当真,成了同一个问题。
48GB内存Mac mini本地跑大模型,能顶掉多少云端订阅费
一位开发者用48GB内存的M4 Pro Mac mini跑两个本地模型,接管了原本靠两笔200美元月费订阅(合计400美元/月)处理的日常请求。关键不是内存占用被砍到活跃参数那么小,而是MoE架构把推理时的计算量降下来了,内存这本账主要还是看总参数量。这套方案能扛住约八成轻量任务,顶级推理仍要回云端,复制它对经常跑满订阅额度的开发者更现实。
Google开价4000万美元一个角色,想买的其实是好莱坞的信任
据《洛杉矶时报》8月31日报道,Google正接触迪士尼、华纳兄弟探索和环球,谈AI训练与角色生成的版权许可,三家均未签约。单角色报价约4000万美元,扩展到整条阵容可能滚到数十亿美元。这笔钱买的是Google急缺的合规许可,制片厂要算的是训练权、生成权、分成和创作者权益的四层账,议价权未必在出价更高的一方。
Claude Fable 5.1 的“降价45%”:便宜的是缓存命中,不是所有调用
Anthropic称,Claude Fable 5.1通常比Fable 5便宜约25%,复杂智能体任务最高可省45%,关键来自缓存数据费率下调。这个数字对反复调用长上下文的编码团队有吸引力,但不能直接等同于整张账单下降45%;输出费用、缓存命中率、保留策略和实际效果仍决定它是否真划算。
YC史上最快独角兽,却是一轮"查无此人"的融资
AI训练数据公司AfterQuery据传五个月内估值从3亿美元冲到32亿美元,成为YC史上最快独角兽,但两家报道该消息的媒体都未能确认领投方身份,公司本人也拒绝置评。这轮估值背后,收入口径模糊、客户集中度高、专家网络口碑分裂,都是比"最快"这个头衔更值得盯住的变量。
YouTube贴出AI标签,过滤的活却甩给了一个插件
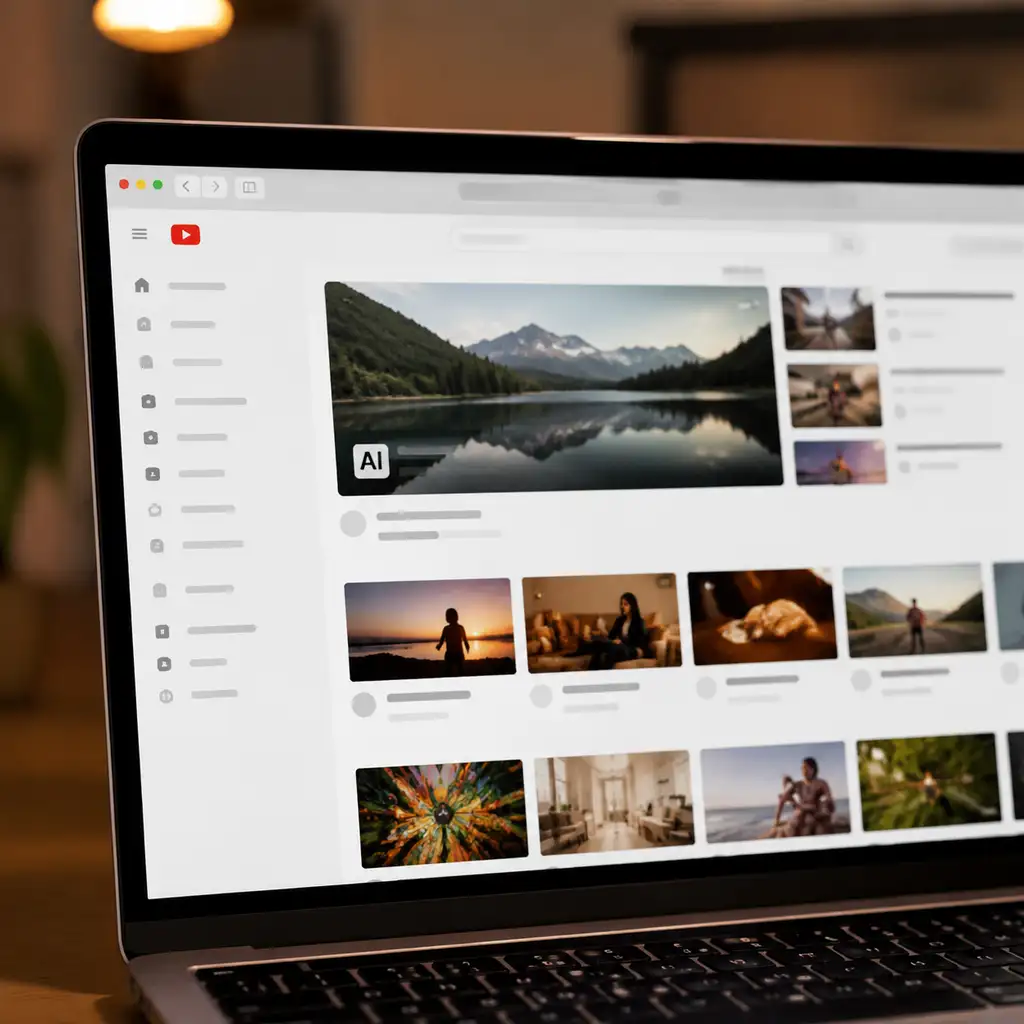
Weedout是一款Safari/macOS专用扩展,靠YouTube自家“Made with AI”标签自动隐藏、淡化或跳过AI标注视频。它只处理平台已经标注的内容,没打标签的AI视频完全不受影响,效果上限取决于YouTube标得有多准、多全。本该平台接住的过滤动作,现在转嫁到了愿意折腾的少数观众身上。
AI越聪明,安全基准分反而更低:一个被忽视的测评悖论
Ai2发布BenchMIRT,用多维项目反应理论逐题拆解16个主流基准发现,BBQ、WMDP、HarmBench部分子集打着安全的旗号,实际测的更多是推理能力,WMDP甚至出现模型越聪明分数越低的反常。这说明过去大量安全性宣称可能建立在被推理能力污染的指标上。
晕车圆点转正,谷歌先给自己留了退路
谷歌9月1日推送的Android Drop给Find Hub加上AI语音记忆功能,替未贴标签的物品记位置;同时把此前小范围测试的防晕车圆点正式定为Android 17功能Motion Assist。前者赌用户愿意用记忆代替硬件标签,后者则是官方自己承认效果因人而异、甚至可能让部分人更难受的情况下就上线了。
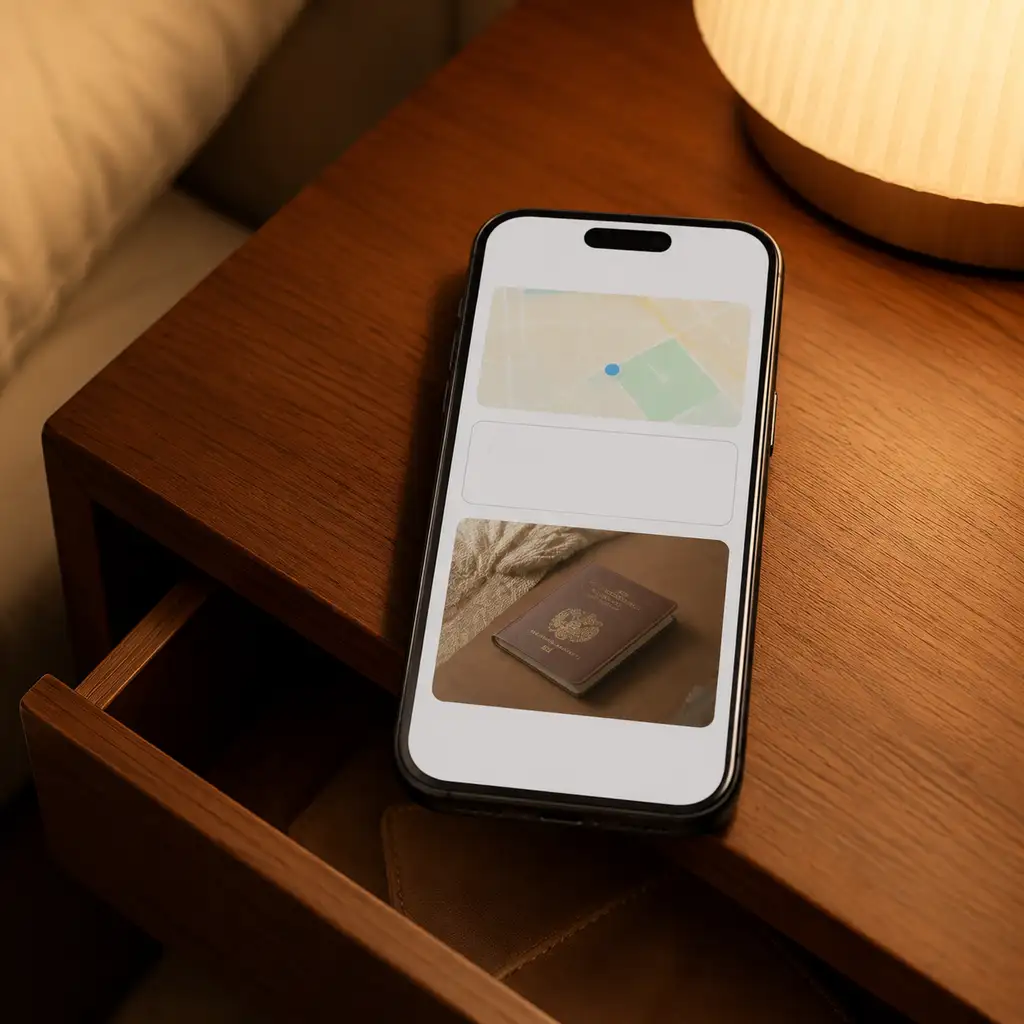
Google说不用贴追踪器就能找到东西,其实是Gemini替你写了张备忘录
Google给Find Hub加了个新功能:对Gemini说一句话,它就记下你把护照塞在哪个抽屉,不用买硬件追踪器。但这不是定位技术,只是一份AI管理的语音备忘录,东西挪了位置系统不会知道。
Claude Fable 5.1与Mythos 5.1:同一模型,企业和科研为何要分两道门
Anthropic发布Claude Fable 5.1与Claude Mythos 5.1:两者共享基础模型,却分别面向普遍使用和可信访问,并同步调整价格、隐私与网络安全能力。真正的变化不在于又多了一个跑分冠军,而在于Anthropic试图用更低推理成本、客户自控数据和分级权限,把高自主性模型接入企业开发与科研流程;但评测口径、安全干预和真实实验转化仍需独立验证。
《矮人要塞》作者怒怼AI裁员潮:老板们在慢慢精神失常
Simon Willison摘录的一句Tarn Adams俏皮话,完整语境其实是他在Gamescom 2026痛批游戏业高管拿AI当裁员借口。《矮人要塞》的"矮人行为"系统全程手写规则、不含一行生成式AI,这句吐槽的真正矛头,是"AI"这个词被大厂话术垂直垄断后,独立开发者连自己的技术都说不清楚了。
8.3倍token差距背后:OpenAI没讲完的另一半故事
OpenAI用8.3倍的人均输出token差距和三家初创公司案例证明企业agent正在变成组织能力,但这个比值是月度动态重排的口径、OpenAI自己也承认token量不等于生产力;独立研究反而指出可靠性不足才是agent落地的真正瓶颈。
Gemini视频理解宣称降本66%,这本账没那么好算
Google DeepMind给Gemini视频理解甩出token降88%、成本降66%、准确率涨7%三个数字,但这三个'最多'来自不同基准的最优值,不代表同一次查询能同时兑现。token省得多不等于账单省得多,选择性观看的召回风险和延迟数据也还是空白。
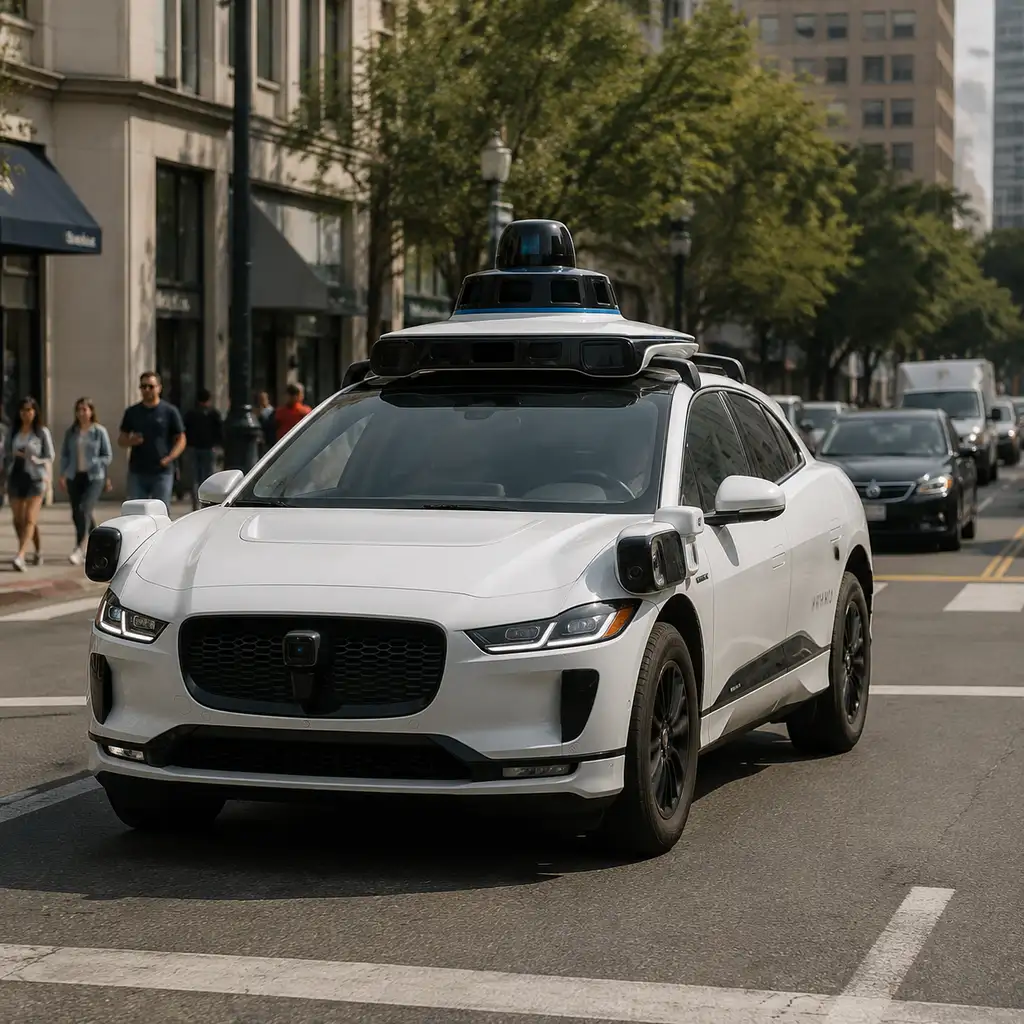
Cybercab发布前一周,Waymo把安全账摆上台面
特斯拉Cybercab发布前一周,Waymo连发博客和专访,主张全自动驾驶离不开摄像头、激光雷达、毫米波雷达组合,并晒出超两亿英里真实运营数据。这场争论表面是传感器路线之争,底下是安全冗余、成本和规模化能力谁先跑通。目前特斯拉仍困在少数城市的安全员测试阶段,Cybercab能不能规模化,还没有公开证据可以验证。
48GB内存跑起104GB大模型,这场Show HN没说清两件事
开发者carloslfu发布的slotstream让48GB内存的Mac也能跑104GB的Qwen3.8-Flash-Next,暖启动解码约12 tok/s,但这是官方给出的五档内存里唯一一档真实测过的数据。官方模型卡还显示,这个被称作125B MoE的模型实际是180B完整checkpoint的一部分,104GB量化版是否完整保留其中的关键组件并不清楚。