人工智能资讯 第62页
聚合当前分类下的最新内容,按时间顺序查看第 62 页精选文章。
十天五起故障,Claude状态页连型号都报错了
9月3日Anthropic状态页挂出一条模型错误率升高通告,但比对官方记录发现型号名字对不上——这只是过去十天内至少第5起同类故障。问题不只是错误率,是模型代号越滚越多之后,连官方自己的故障记录都开始记混。
英伟达同意129.3亿美元收购Hugging Face,真正贵的是开源AI入口
英伟达同意以129.3亿美元收购Hugging Face,交易尚未完成。约1.5亿美元的年化收入解释不了这个价格,真正被定价的是模型分发、开发工具和社区入口;公司承诺保持开放,但这份承诺要经受硬件利益冲突的检验。
Zoox抢先开进拉斯维加斯机场,但『8000辆』的许可账对不上
Zoox本周把付费无人出租车服务开进了拉斯维加斯Harry Reid国际机场,成为目前唯一能直接接送到行李提取处的机器人出租车公司,比Uber、Lyft方便不少。但行业里流传的『内华达已批出8000辆机器人出租车许可』的说法,跟官方数据对不上,真实合计更接近7100辆,且120天的强制运营期限意味着Zoox的独家窗口不会太长。
22.6%到29.7%,还是21.1%到44.9%?一份GRPO教程漏说的数字
Liquid AI公开的GRPO微调教程称,350M小模型100步训练能把结构化输出合规率从22.6%拉到29.7%,但同一模型、同一基准下,官方RL训练成绩是21.1%到44.9%,涨幅接近教程版本的三倍。更扎眼的是,有独立实验显示纯约束解码不训练也能让该模型结构合法率冲到100%,这动摇了必须靠GRPO才能解决结构化输出的默认前提。
AI水彩画火遍全网,开源复现揪出了审美强化学习真正的死结
Hugging Face工程师开源复现了那条刷屏150万次的AI水彩画视频背后的训练方法,四项奖励配方全公开、一条命令可跑。但复现过程暴露的真相是:最初9项奖励让模型卡死在同一个分数上,靠砍掉冗余评委才重新学会画画,而支撑一切的参考图库本身全部由AI生成筛选而来,没有一张真正的人类水彩。
两人巡演团队靠ChatGPT把三天活干成三小时
美国一家两人经营的越野摩托巡演公司用ChatGPT Work自动核查活动信息、管理商品库存,周耗时从8小时压缩到1小时,补货流程从两三天缩到两三小时。这是OpenAI自己发的客户案例,效率提升真实但样本单一,网站AI流量暴涨1223%也不等于卖出更多票。
Uber伦敦机器人出租车抢先上线,方向盘后却还坐着安全员
Uber联合英国自动驾驶公司Wayve在伦敦推出网约车服务,抢在Waymo之前落地,但车内仍配备持牌安全员,属于伦敦交通局私人租赁牌照下的监督载客,并非真正的无人商用服务。真正决定谁先跑通伦敦机器人出租车的,是英国DVSA主导的自动化乘客服务许可审批,这一门槛目前无人跨过。
创业大会的AI焦虑,被TechCrunch做成了一门生意
TechCrunch公布了Disrupt 2026创业者舞台Builders Stage的首批议程,门票899美元起、预计吸引万人规模。把完整场次摆开看,多数议题其实是在回应一种共同情绪:创业者对被OpenAI、Anthropic这类大模型巨头随时“团灭”的恐惧,这比嘉宾名单本身更值得留意。
OpenAI新推理术引爆安全警报,官方文件却查无'opaque recurrence'一词
The Information援引消息源称OpenAI新模型Astra采用不透明循环推理技术,可能削弱AI安全社区赖以监控模型行为的思维链工具,引发Redwood Research等机构警觉。但OpenAI官方文档从未出现这一术语,安全社区内部反应也远非一致,真正的悬念在于这项技术未来能被放大到什么程度。
Meta新编码模型跑分:一项打平GPT-5.6,其余全线落后
Meta发布编码模型Muse Spark 1.3,官方跑分显示只在Terminal-Bench上追平GPT-5.6,其余多项落后,却打出“可与前沿模型竞争”的旗号。真正值得琢磨的是它的两档定价:便宜九折的那一档,换的是你上传的代码和数据训练权。
Gemini 3.8 Flash上线:思考等级不是分级计费,跑分却相差70个百分点
llm-gemini 0.34加入Gemini 3.8 Flash支持和一个异步调用bug修复,但真正值得说清的是它带出的两件事:所谓的low/medium/high思考等级并不分级计价,费用差异只来自实际token消耗;而Google公布的基准分数里,同一模型在Terminal-Bench新旧版本上的成绩相差70个百分点,说明跑分口径本身就不稳。
DOJ为OpenAI训练AI辩护,但只护住了一半责任
美国司法部9月1日在纽约南区法院就OpenAI版权案提交20页意见陈述,力挺AI训练适用合理使用原则;但文件明确把训练、数据获取、模型输出三件事分开谈,并未说训练材料的使用全部合法,这条边界恰恰是下一轮诉讼最容易被攻破的地方。
0.0041%假阳性率背后:AI检测正在放弃“真假”二分法
Pangram联合创始人Max Spero在访谈中点出一个技术转向:AI检测正从“是不是AI写的”二选一,变成判断“AI参与了多少”的光谱分类,其新模型Pangram 4的官方基准和第三方研究部分印证了这套思路,但假阳性风险仍不成比例地压在ESL和神经多样性写作者身上。
死亡帽识别率仅46%,AI认蘑菇的高分背后藏着什么
Quesma团队用1,040张真实蘑菇照片测试16个多模态大模型,Gemini 3.6 Flash综合准确率最高且比多数frontier模型更便宜,但死亡帽等致命物种的识别率只有46%,17%被误判成可食用近似种。整体跑分越漂亮,越容易掩盖这类致命型错误,这才是真正该盯的风险。
纽约州长候选人用AI合成曼达尼与霍楚尔,争议不只在画面诡异
纽约州共和党州长提名人发布AI视频,把佐赫兰·曼达尼与凯茜·霍楚尔放进近似处方药广告的场景。它未必能让观众相信某件事真实发生,却能低成本制造政治关联;判断争议大小,还要看标签、投放范围和传播数据。
IBM把预测模型塞进Confluent数据流,省的是搭建不是判断
IBM与Confluent宣布把四款Granite时间序列基础模型接入Confluent Cloud,企业可以用Flink SQL直接调用做预测和异常检测,目前仅限Early Access且先在AWS开放。真正该看的不是模型多新,而是流内推理能否把部署成本降到企业愿意为长尾场景买单的程度。
Claude突然不背歌词了,三天前它刚被索尼华纳告上法庭
Anthropic给Claude Fable 5.1加了一大段拒绝复现歌词、诗歌、版权角色的系统提示词,时间点紧贴索尼音乐出版和华纳查普尔起诉Anthropic的诉讼。这层护栏只管claude.ai网页和App,不管开发者调用的API,更像是给消费端产品套的一层免责话术,训练数据源头的官司还没真正开打。
三个网站造出21万篇'最佳软件'页,Perplexity照单全收
研究机构Trellner用760次调用测试Perplexity的sonar系列模型,发现近六成引用来自Tranco排名10万位之外的冷门域名,其中三个疑似同一运营方的站点用18篇博客撑起21万篇AI生成的'最佳软件'页面,还把首页标题直接写成'Facts & Grounding Page'。这不是老套的内容农场刷排名,而是专门针对AI检索机制设计的定向投喂,目前只证实对Perplexity生效。
Cybercab 在奥斯汀公开载客:特斯拉的摄像头路线迎来现实检验
2026年9月,特斯拉在得州奥斯汀启用搭载改版 FSD 的 Cybercab 公开载客,车辆没有方向盘,并由远程操作员监控。服务启动只能证明特斯拉开始进入真实运营,尚不能证明其摄像头方案已经实现完全无人驾驶;安全冗余、远程介入和事故责任才是接下来要核验的核心变量。
从7起到37起:OpenAI的Tumbler Ridge官司,'协助教唆'这顶帽子扣得住吗
Edelson PC本周在加州追加30起诉讼,把针对OpenAI的Tumbler Ridge枪击案诉讼总数推高到37起,并首次指控OpenAI'协助教唆'而非单纯疏忽。这个诉因法律门槛极高,原告自己也承认关键指控只是'信息与推测';真正致命的,是OpenAI案发前后对同一份聊天记录给出两套相反的风险判断标准。
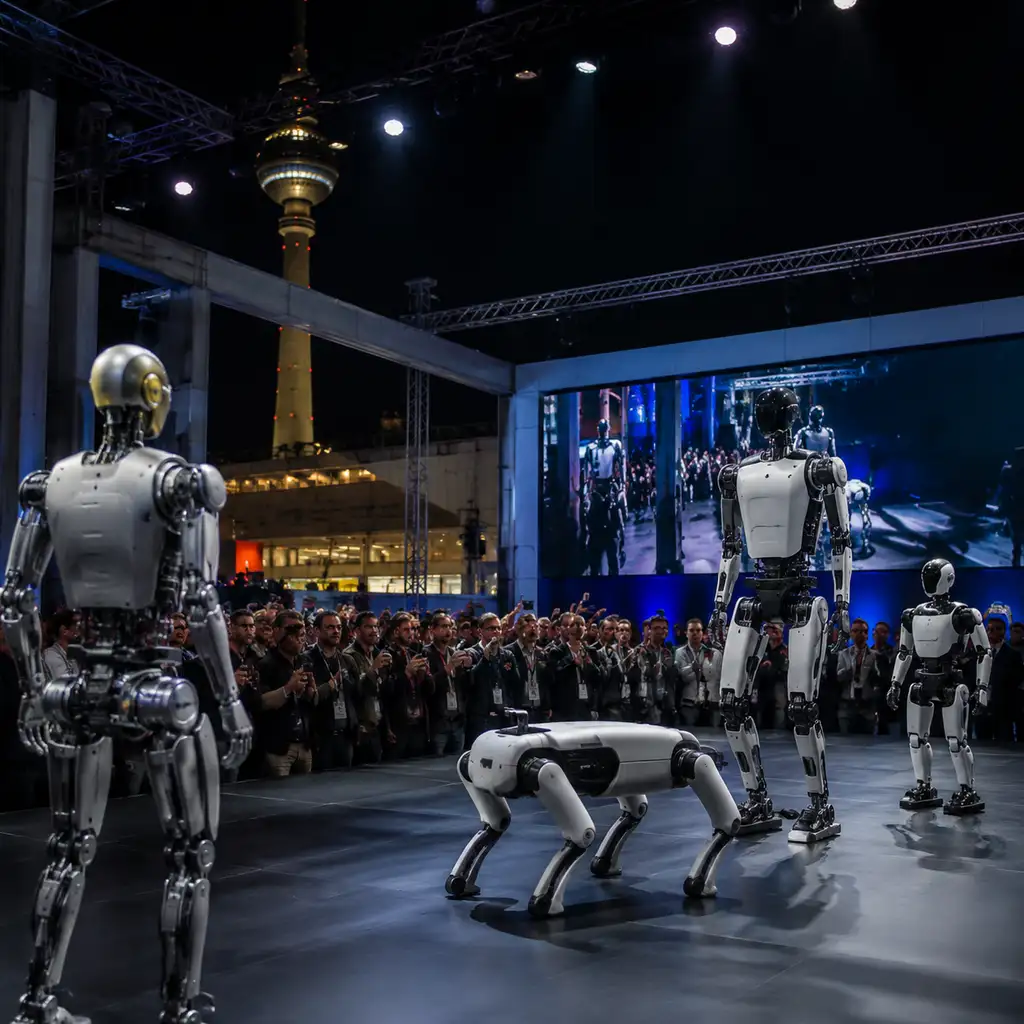
IFA机器人秀场调查:号称六台人形,过半不是双足
IFA柏林机器人走秀阵容里,过半参展方展示的其实是可变形四足、工业四足或陪伴型机器人,并非严格意义上的双足人形;LG CLOiD训练数百台机器人构建机器人基础模型的故事,也并非本届IFA官方发布内容。这说明‘人形机器人逼近家庭’的叙事被媒体简化放大了,真正瓶颈仍是能在混乱环境里自主决策的调度大脑,而不是一双腿。