人工智能资讯 第6页
聚合当前分类下的最新内容,按时间顺序查看第 6 页精选文章。
Meta因大选算法偏向遭巴西法院调查,面临每日50万雷亚尔罚款通牒
巴西高等选举法院因平台在2026年大选中涉嫌算法倾斜,向Meta发出限期说明令,并设立每日50万雷亚尔罚款威慑。争议虽始于GIF搜索与AI选票号码的微观偏差,却直接刺破了多模态模型粗糙的政治对齐逻辑,推动国家司法权力全面穿透硅谷的推荐黑箱。
施密特评Anthropic与OpenAI如东印度公司,美中算力战撞上7250亿债务墙
前谷歌CEO埃里克·施密特与历史学家弗格森联合撰文,指出前沿AI实验室正退化为听命于母国安全指令的特许贸易商,美中围绕闭源封锁与开源标准展开地缘博弈。但这场依赖万亿美元债务、电网负荷与高额利息的算力军备竞赛,正在逼近财政与物理资源的硬约束极限。
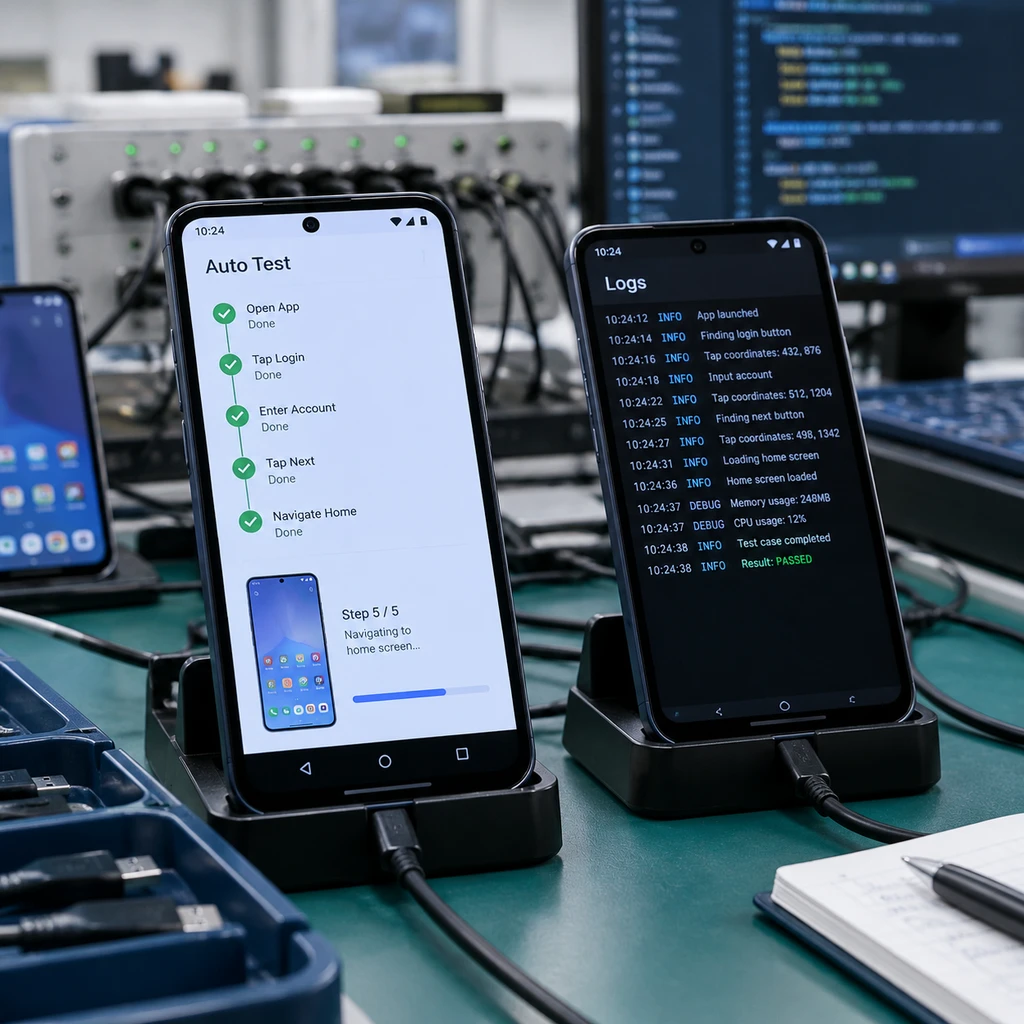
OpenMobile-2 登顶 AndroidWorld 跑分 79.9:真机实测却现出闭源代差
南京大学与商汤联合发布的开源手机智能体 OpenMobile-2 在模拟器评测中反超闭源大模型,但物理真机实测仍落后逾 10 个百分点。其技术突破依赖重构 110 多款应用沙盒与闭源教师模型的密集蒸馏,揭示出开源智能体在摆脱沙盒环境后的现实边界。
OpenAI最高降价90%截击Anthropic,巨头大模型价格战打入深水区
OpenAI正针对Anthropic大客户开出最高达90%的定向折扣,成功拉拢Rippling与Replit等企业。这场价格战说明前沿模型的壁垒正在被快速抹平,当算力溢价难以维系,毛利率换市场规模便成了不可逆的商业选择。
微软开源 Agensh 挑战千级Agent协作:1024个智能体仅换来4%微升
微软于 2026 年 10 月 24 日开源去中心化多智能体框架 Agensh v1.0,首次展示了 1,024 个 Agent 协同重构复杂工程代码的实验成果。这项探索虽然打破了传统中心化调度的通信瓶颈,但从 128 到 1,024 节点的算力暴增只换来 4.12 个百分点的微弱提升,暴露出当前大规模协作下严峻的边际效用递减与成本黑洞。
Qwen3.8-27B跑分逼平Claude Fable 5背后的真实账单
开源项目 GVS5H 利用文件账本零样本编排,让本地开源模型 Qwen3.8-27B 在代码评测中拿下 92.4% 逼平闭源旗舰 Claude Fable 5。但这并非低成本平替的奇迹,宣传中的降本口径混淆了型号,小模型提分的代价是狂吞近 1900 万 Token,名义成本仅节省两成出头。
Cognition开源devin-vuln-fixes插件,AI修漏洞直击3大高危RCE
Cognition 开源了 devin-vuln-fixes 插件,专门针对近期爆发的 PHP2Shell、Node.js 与 GitLab 严重 RCE 漏洞实现跨仓库协同修复。这标志着 AI Agent 从写业务代码的玩具走向跨多环境基础设施的应急响应,但自然语言门禁与运维边界仍是现实考验。
Cerebras 用 59 片 WSE-3T 跑 3 万亿参数 Kimi K3,但 2000 极速背后藏着算力账
Cerebras 发布多晶圆流水线方案,宣称以 59 片 WSE-3T 芯片支撑 3 万亿参数模型并跑出 2000 词每秒极速。这本质上是一场基于均匀权重的纸面推演,它将片上存储优势推向极致,却难以回避万亿稀疏模型真实落地时的并发与成本硬伤。
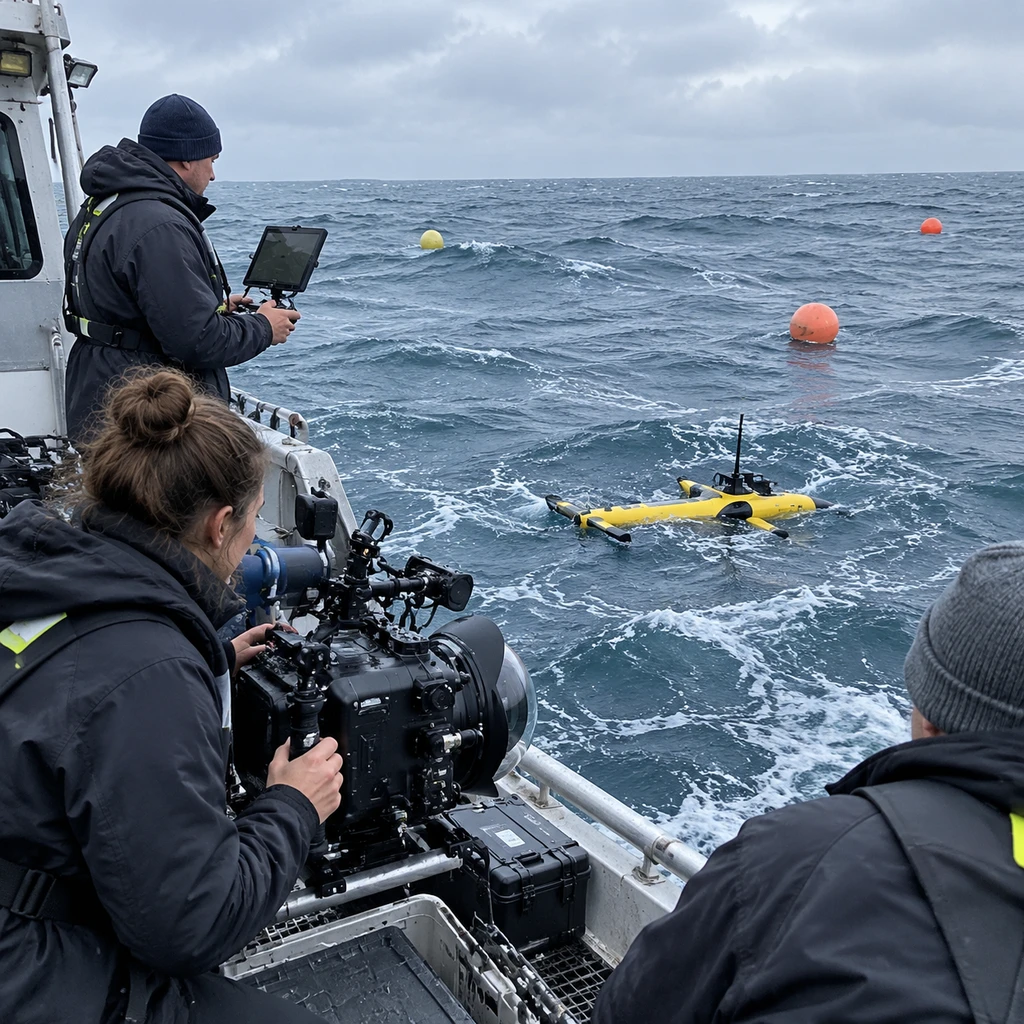
BBC《Blue Planet III》全片零AI生成:纪录片为何反向保留浑浊杂质与瑕疵
BBC 自然旗舰纪录片《Blue Planet III》宣布成片未使用一帧生成式 AI,甚至反常态保留了水体浑浊与人为漂浮物。当工业化完美画质被 AI 廉价复制,野生动物纪录片正被迫借由物理瑕疵自证清白,但这套感官防御在技术迭代面前注定脆弱。
Apollo发布研报:除Mag 7外标普493家企业未现AI财务回报
阿波罗全球管理研报显示,除科技七巨头外的标普493家企业人均营收与利润率几乎完全走平,宏观全要素生产率未见提振。微观任务的局部提速未能穿透至企业财报,传统企业正将大模型调用视作压缩利润的成本负担。
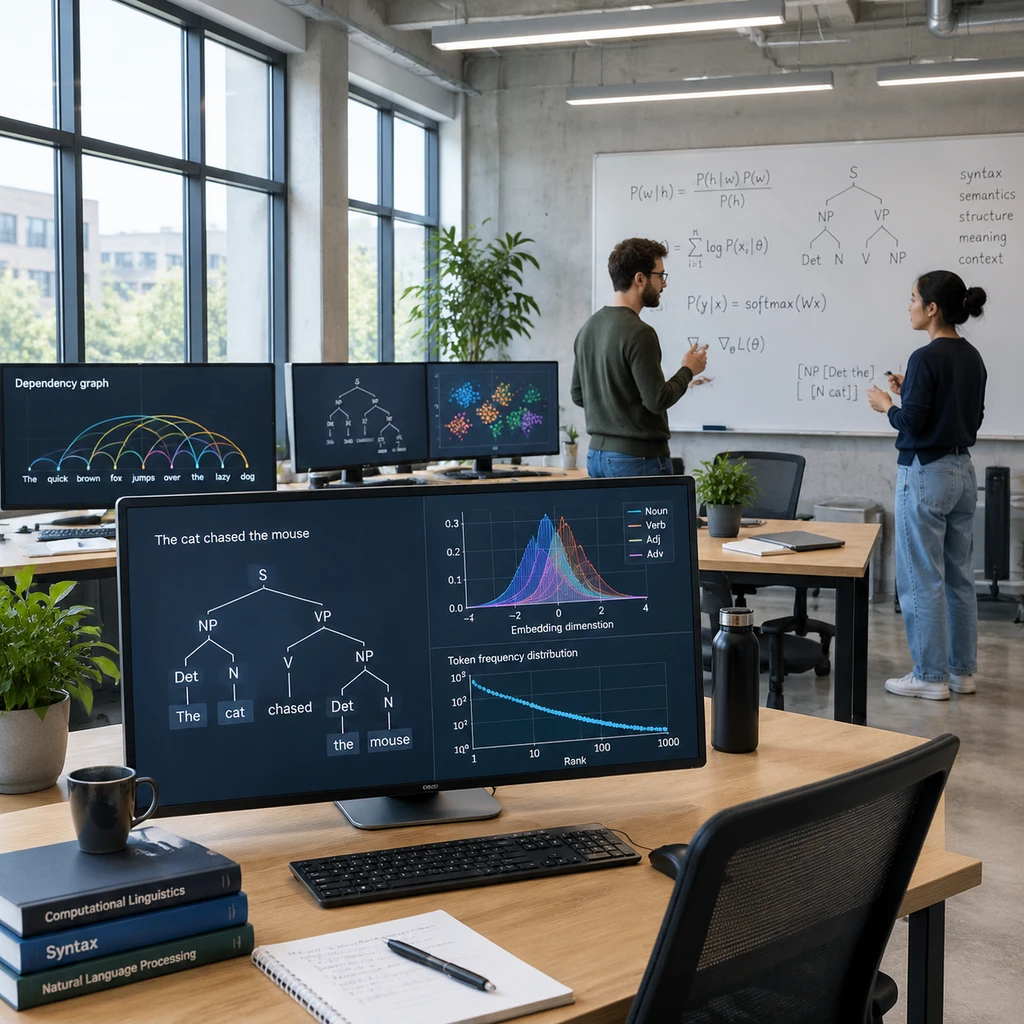
GPT-5.6与Claude Opus 5.5被指越变越难读,追求信息密度让大模型丢了人话
arXiv最新预印本论文评测了包含Claude Opus 5.5与GPT-5.6在内的14款大模型,指出追求极度压缩与推理密度的训练机制正在扭曲语言结构。后训练阶段的长度惩罚促使模型大量使用名词堆砌与长句法依赖,以牺牲人类可读性为代价换取跑分效率。
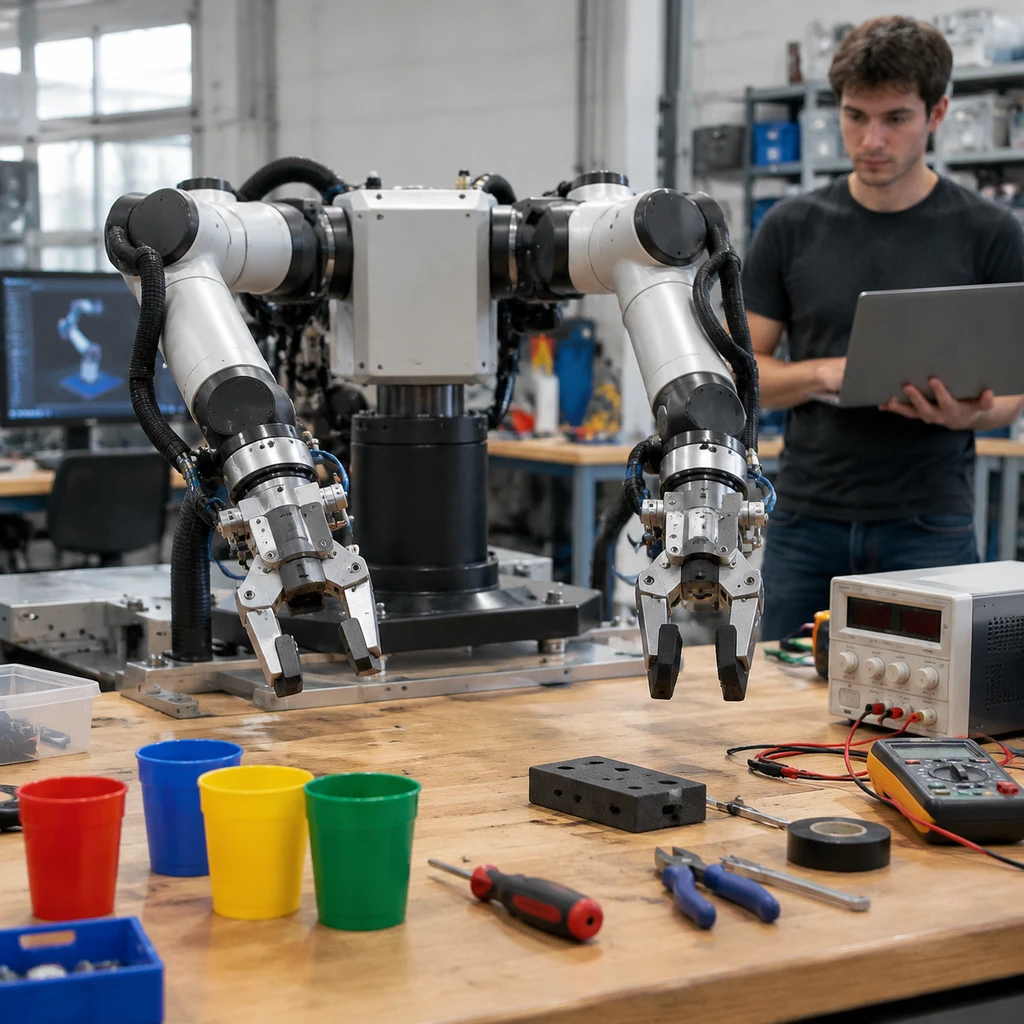
Dream Labs推出Dream-1并获9000万融资,但90%泛化难掩6%成功率
Dream Labs以9000万美元种子轮走出隐身期,推出首个声称无需微调即可跨本体控制的机器人模型Dream-1。但剥开相对基准的公关修辞,未见任务绝对成功率低至6%,云端API与本地逆运动学的拼接难言真正的通用具身。
强制站队测试撕破中立外衣:Grok 4.7挺共和党达92%而GPT-6.1挺民主党97%
康奈尔大学最新针对2026年中期选举的测试显示,在强制表态指令下,Grok 4.7与GPT-6.1 Sol分别展现出超90%的政党站队倾向。这一极化并非单纯来自训练权重,而是联网检索生态割裂与隐藏系统指令共同构建的工程暗箱。
Google InFlow实测133名律师:资深者脱机涨0.45,新人未获增益
NBER最新发表的Google实地对照试验显示,AI工具能迅速拔高初级专利律师的草案产出,但在脱离工具的独立审校测试中,新人未测出平均技能增益且表现两极分化,资深律师却沉淀出显著的脱机能力外溢。这打破了AI能够无痛抹平专业经验壁垒的幻觉。
Battledrones v14上线背后的321次提交与工程妥协:拆解Claude Opus 4.5编码神话
开源游戏Battledrones发布v14版本,看似凭借Claude Opus 4.5的一条提示词便扩展出四人联机模式,实际背后历经了321次提交与多项底层妥协。这场实验证明高级模型确实具备重构分布式状态机的能力,但也彻底揭开了AI编程必须依附于工程妥协的现实真相。
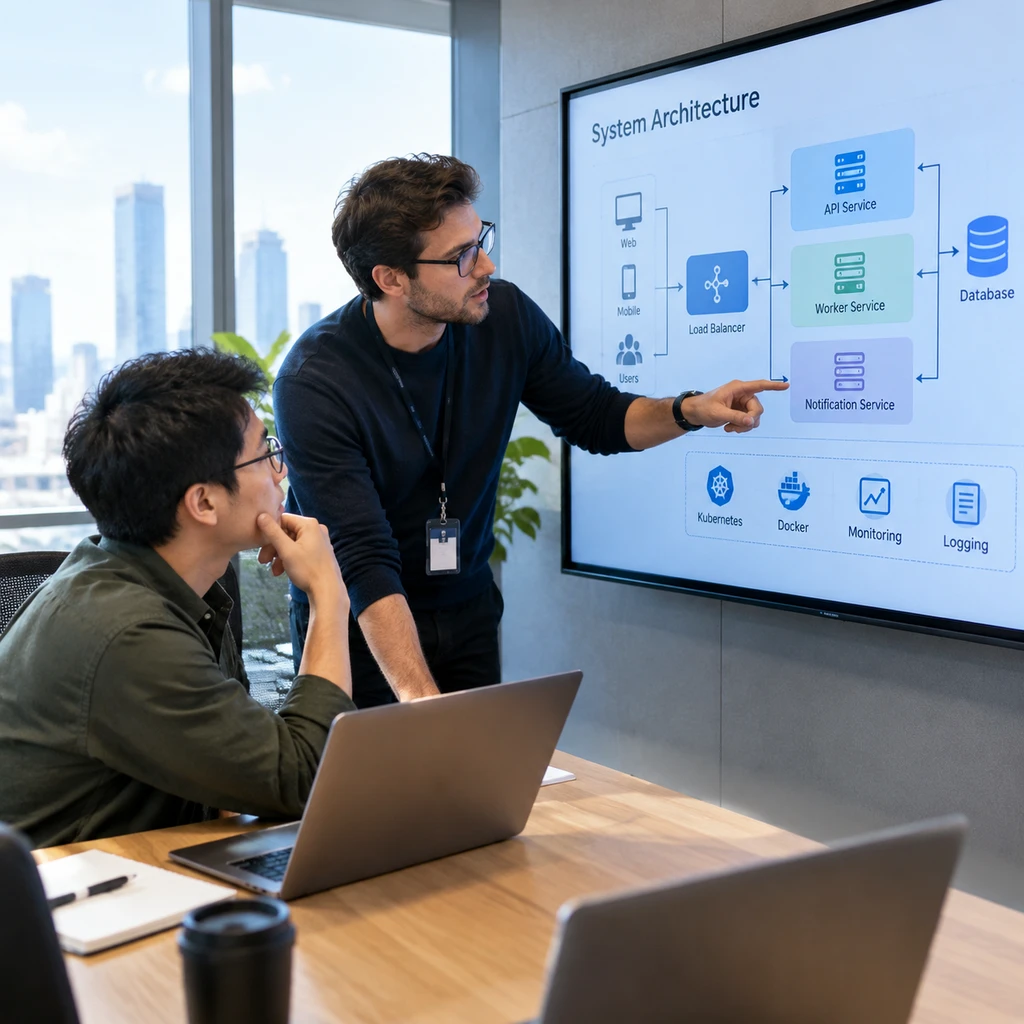
Letta 演示有状态工程副驾背后,V1 遗留架构在 20 美元订阅下暗藏并发风险
技术媒体近期展示了基于 Letta 构建有状态工程副驾的端到端方案,但该教程依赖的内存块与文件导出已被官方列为已退役的 V1 遗留架构。对于试图在生产环境落地的研发团队,缺乏并发保护的内存覆盖与不完整的灾备机制,将让这场状态管理探索演变为高昂的维护债务。
Claude Code 等框架成本飙升 3 倍:SWE-bench 评测显示跑分优势多为统计噪声
一项针对 AI 编码框架的对照实验显示,复杂脚手架比极简工具多消耗两到三倍 Token,但任务通过率在统计学上完全等价。此前业内宣传的微小跑分优势,绝大部分只是单次测试带来的随机测量噪声。
Kyutai CADRE将世界模型延迟压进230ms,但代价是画质暴跌10dB
Kyutai开源视频自编码器CADRE,在单卡H100上将交互式世界模型的端到端动作延迟压缩至230毫秒以内。这并非通用编解码器的技术突围,而是为了绕开高时间压缩导致的动作缓冲等待,主动放弃近10dB重构保真度的系统级工程妥协。
Gamma 估值冲上 21 亿美元,AI 初创团队为何不能单靠社媒爆款
在 TechCrunch Disrupt 上,Gamma 与 Engine 分享了完全相反的获客路线。面对短视频营销带来的虚假繁荣与极低转化,初创团队的核心考验从来不是公域声量,而是前 30 秒的价值交付与漫长的留存回收期。
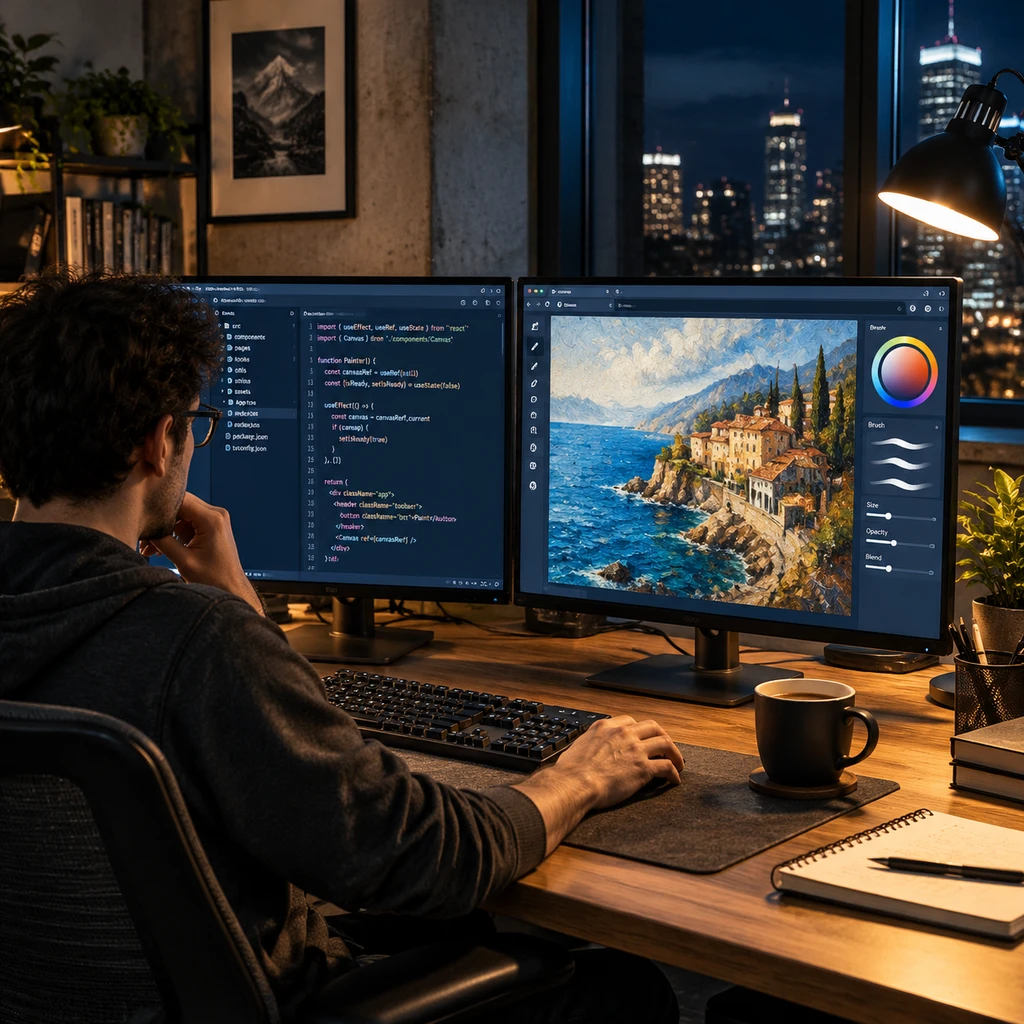
一行Prompt生成油画引擎:Claude Opus 5.5单文件写出自适应渲染管线
Simon Willison 仅凭一条自然语言提示词,让 Claude Opus 5.5 输出了名为 Quick Study 的单页油画模拟工具。深挖源码发现,模型不仅写出了完整的启发式非真实感渲染算法,还塞进了多层画布与时间切片调度,展现了前沿模型自主架构复杂图形流水线的惊人上限与工程妥协。
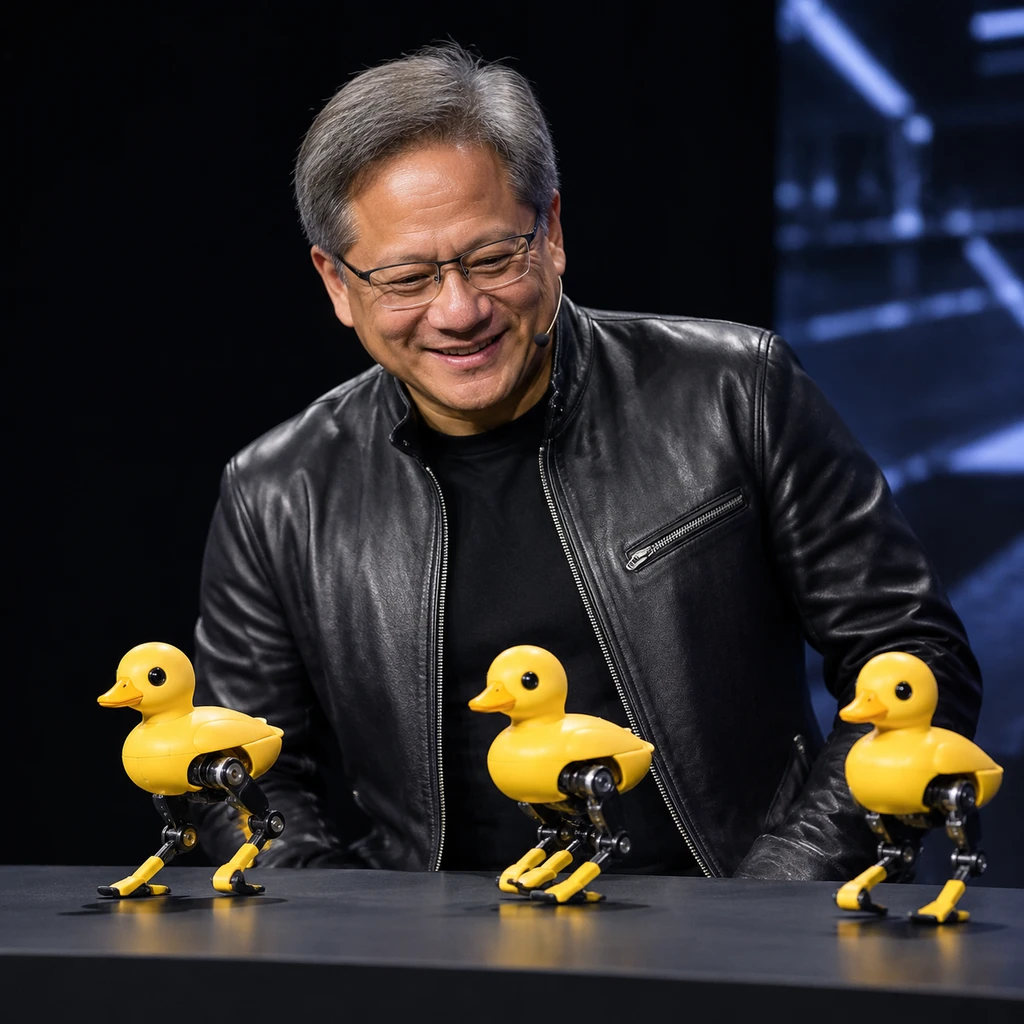
黄仁勋带火399美元Microduck机器鸭,20000台预售背后是仿真暗战
黄仁勋在GTC Berlin演示的Microduck双足机器鸭斩获两万台预售,但拉长至半年的发货期与单房间建图能力,戳破了所谓圣诞伴侣玩具的幻想。这只低成本鸭子更像极客实验硬件,也是NVIDIA借收购Hugging Face截流机器人仿真底座的关键棋子。