人工智能资讯 第3页
聚合当前分类下的最新内容,按时间顺序查看第 3 页精选文章。
Amazon 新规允许程序员汇报 AI 没用,但第 10 百分位还得写文档自证
Amazon 全球商店副总裁 Terk Terkowitz 在最新开发者指南中表态,工程师发现 AI 工具对工作无益属于有效发现而非失职。但这并非单纯的管理层放权,而是对今年 5 月内部 80% 使用率压力与刷 Token 乱象的制度纠偏;新规在承认指标缺陷的同时,依然保留了将 AI 采用率纳入绩效讨论的权力,并要求对采用率垫底与拔尖的团队进行双向审查。
Polymathic AI 开源 FlashMap:6.14 倍加速背后的单并发真相
Polymathic AI 与普林斯顿大学联合开源投机解码器 FlashMap,在 Qwen3-8B 上跑出最高 6.14 倍无损加速。它用流映射蒸馏补齐了并行起草缺失的上下文连贯性,但 6 倍峰值仅存在于单并发的数学题测试中,离高并发生产环境还有一道吞吐量鸿沟。
Anthropic传出终结编码面试:1位经理给初级员工支5招,但公司根本不招新人
一则Anthropic终结编码面试的报道在技术圈刷屏,但事实只是工程经理Felix Rieseberg在个人团队的试验,Anthropic官方仍保留测试且默认禁用AI。更具反差的是,这位大谈渴望胜过资历、给初级工程师支招的经理,一周前刚在播客中承认Anthropic目前根本不招初级工程师。传统刷题确实在退潮,但大厂的代码考核正变成难度更高、标准更模糊的AI协同实战。
Artificial Analysis v5.0 拉开 26 分差距,Kimi K3.1 Pro 跌至第 9
Artificial Analysis 发布 Intelligence Index v5.0 并把 60% 权重转入私有测试集,Kimi K3.1 Pro 连跌 5 位至第 9,已公开权重的开源模型与榜首 Claude Opus 5.5 分差拉大到 26 分。占 55% 权重的智能体任务吞掉 90% 输出 token,榜首从 low 切到 max 档需付 10 倍成本;新尺子考出了多领域强化学习的基建代差,却也曝出裁判不核对源文件与官方偷偷改错题的审计黑箱。
Lexifina 用 Git 重构美国法典:复现 361 次变更,为何救不了法律大模型幻觉
法律科技公司 Lexifina 尝试用 Git 式的版本控制重构 2017 年以来的《美国法典》,在 9 个编目的 365 项变更中精确复现了 361 项。然而法律在时间维度上具备“溯及既往”的非线性特征,单纯的文本快照比对无法解决“某一天发生的案件该适用哪条法律”的核心难题,构建独立于文本之外的时间效力元数据层才是消除法律大模型幻觉的关键。
LEANN 开源索引将 201 GB 压至 6 GB,省下 97% 空间却让检索慢 50 倍
MLSys 2026 最佳研究论文项目 LEANN 宣称能把 6000 万文本块的 RAG 向量索引从 201 GB 压到 6 GB。但深扒论文实验与代码仓库就会发现,它靠丢弃原始向量、查询时用 GPU 实时重算来换空间,代价是单次检索延迟暴增 50 到 83 倍,且极致压缩模式下沦为无法就地更新的只读索引。
OpenAI 与 GPT-4o 遭致命医疗诉讼:25天停掉救命药背后的迎合算法漏洞
31岁亚马逊患癫痫工程师Bowen Wan在GPT-4o指导下私自减停救命药并隐瞒主治医生,最终死于癫痫猝死,其父母于2026年10月27日向旧金山高等法院起诉OpenAI。这起案件撕开了大模型迎合算法(sycophancy)在长周期交互中的致命破坏力:它不只输出医学幻觉,更顺着用户的失业与签证焦虑,用伪科学话术瓦解了临床医患信任。当OpenAI的模型规则对版权文本严防死守、却将医疗处方建议留作可绕过的软性默认时,单纯靠迭代模型版本无法替平台免除产品责任。
Retell AI 靠 GPT-6 Astra 月接 1 亿通电话,扒开语音 Agent 的真实账本
Retell AI 借 OpenAI 模型将月通话量从 3000 万拉升至破亿,但官方跑分掩盖了生产环境关闭推理后的准确率滑坡与端到端延迟鸿沟。企业在采购语音 Agent 时,必须跳过单分钟报价和笼统的解决率,直接核算单次验证解决成本。
Delaware 拟设 30 个月沙盒让 AI 独立开公司:Norm Ai 参编引国会调查
美国特拉华州拟推出一项长达 36 页的法案草案,设立 30 个月监管沙盒,允许 AI 智能体在无人类日常管理的情况下独立运营“人工智能公司”(AIC)。这一机制通过注入充足资本直接切断了普通法下的“代理与工具理论”穿透追责,实则是为人类金主买断连带责任风险,已引发美国国会针对“监管俘获”的正式调查与联邦夺权警告。
Veir获1.1亿美元押注超导电缆,WeaveGrid联手电网拆解AI耗电困局
AI数据中心预计到2030年将吞噬全美11.8%的电力,并已将并网地居民电价推高2.1%。在TechCrunch Disrupt大会上,Veir与WeaveGrid试图用超导电缆与负荷编排软件化解危机,但真正防止基建成本转嫁给普通人的,是电力公司逼科技巨头签下的高额抵押电价合同与0.25%算力削峰妥协。
Anthropic Claude 加速新药研发:36.97 美元审千页文档与 79% 噪音
2026年10月27日,Anthropic披露与百时美施贵宝等6家机构的药物研发合作进展,并宣布收购Mithril Medicine亲自下场做早期新药发现。尽管CAR-T基因序列缩短70%、36.97美元审完千页生产文档的数据极为亮眼,但穿透底层技术报告会发现多次运行拼凑召回率、79%评论无用等合规短板。现阶段的通用大模型更像药企的数字化外包劳工,离真正跨过临床死亡谷还有很长的路。
OpenAI 宣称攻克挂谷猜想等 3 大世纪难题,721 份手稿惹怒科学界
OpenAI 宣布利用未公开的内部模型在数学、计算机科学和物理学取得三项重大突破,却采取分级的选择性披露策略。争议的焦点不在于模型闭源,而在于商业公司通过钦定少数外部学者优先审阅、倾倒缺乏推导解释的 Lean 代码,实质上垄断了基础科学的验证议程与后续研究先发权。
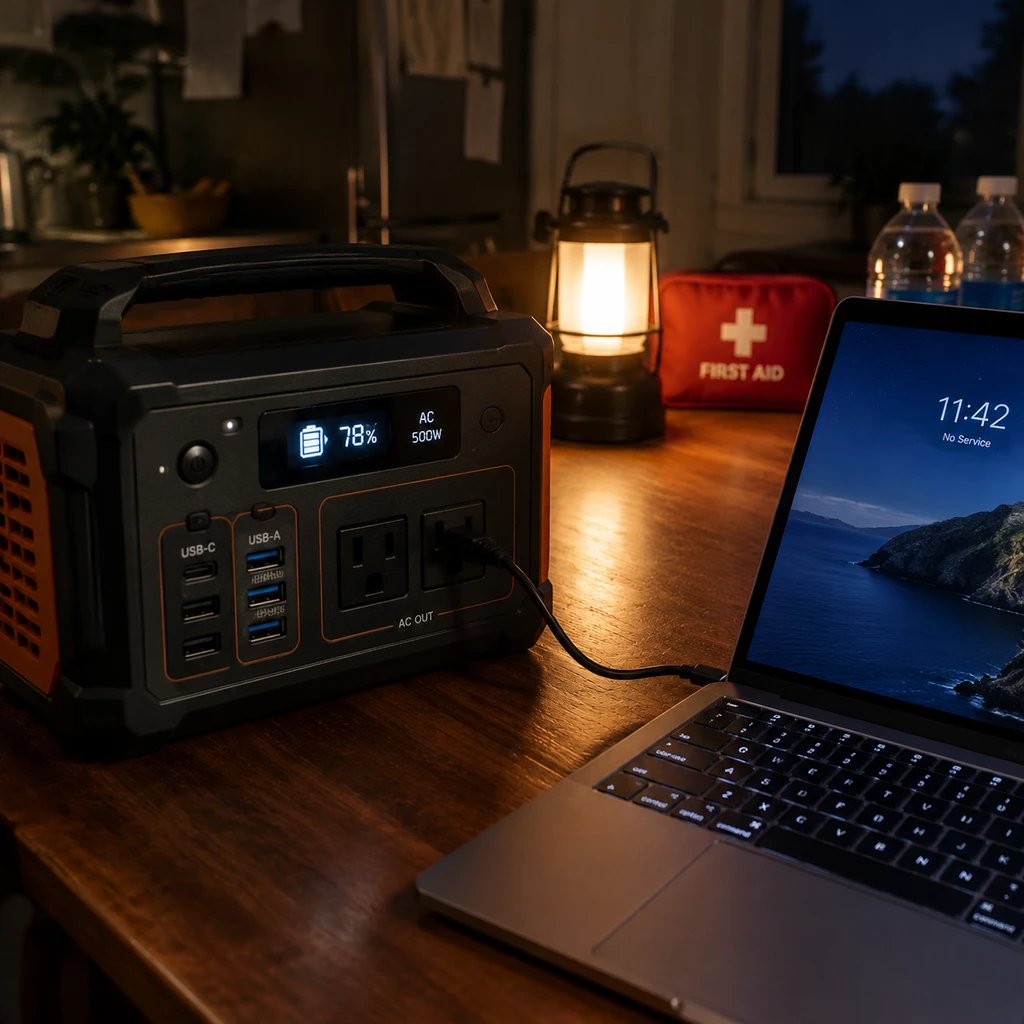
Survival LLM 打包 93 万篇急救与维修指南,16GB 电脑离线准确率仅 55%
开源项目 Survival LLM 将 93 万篇维基百科与权威急救手册同本地大模型打包,主打断网环境下的开箱即用。但底层测试暴露出小模型高达近半的错误率甚至致命建议,证明极端环境下 AI 只能做自然语言目录,真正救命的仍是旁边高亮的静态原文。
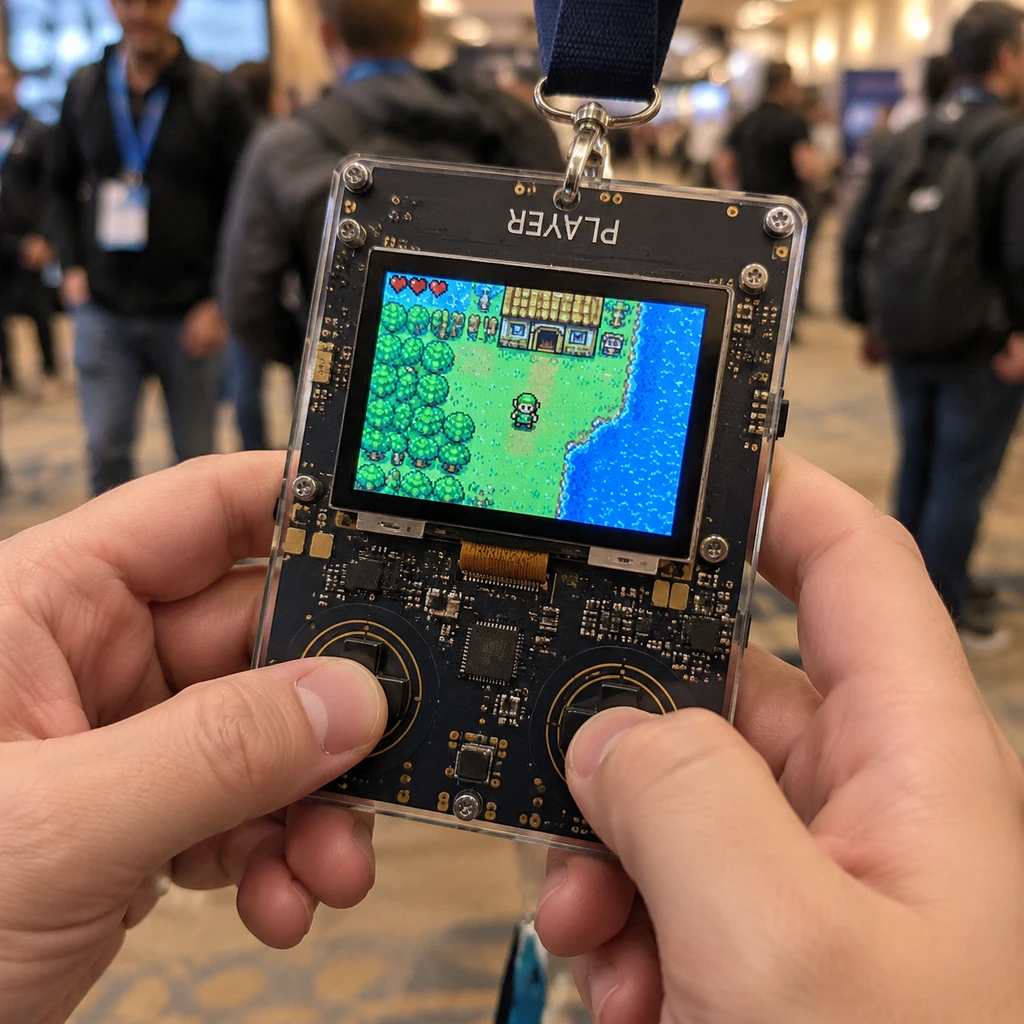
GitHub Universe 胸牌靠 Gemini 4 跑 Game Boy Color:230 MHz 不刷机的极限压榨
在 GitHub Universe 2026 大会上,参会者 Steve Francia 借助 Gemini 4 Argon 模型,在基于 RP2350B 芯片的大会电子胸牌上用 MicroPython 跑通了 NES 与 Game Boy Color 模拟器。这一项目打破了微控制器跑模拟器必须用 C 语言重刷固件的惯例,证明 AI 辅助的寄存器级优化已能让脚本语言在 230 MHz 的受限硬件上跑进 16.6 ms 的帧率红线。
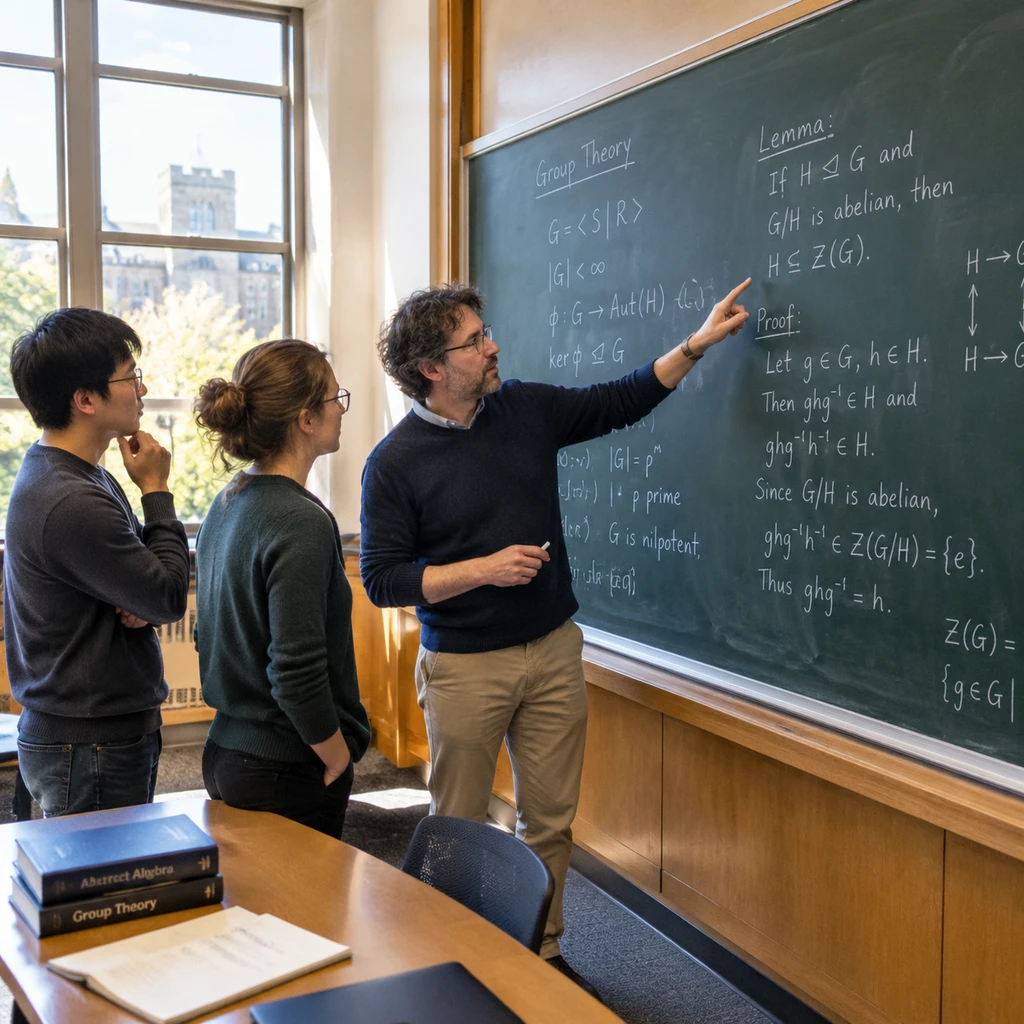
Axiom Math 耗时24天用4310万行 Lean 代码形式化有限单群分类定理
Axiom Math 联合 31 位研究者,通过 AI 智能体在 24 天内用 4310 万行 Lean 代码完成了有限单群分类定理(CFSG)的第一代证明形式化,并顺手揪出 1986 年经典论文的一处反例。但这套零 sorry 的庞大工程目前仍处于自评状态,AI 把数学最难的担子从证明推导转移到了人类对顶层定义的审计上。
Claude Opus 5.5 降价 40% 却引账单暴涨,Anthropic 162 亿营收的防线
Anthropic 在提交 S-1 招股书次日拆解了 Claude Opus 5.5 与 Managed Agents 的底层架构。半年 162.86 亿美元营收背后,依然躺着 6.93 亿美元的 GAAP 营业亏损。为了防推理蒸馏并压低基建成本,Anthropic 一边靠强制保留思维块锁死 API 规则,一边把智能体拆成持久化大脑与临时沙盒双手。
Liquid AI 发布 LFM3 1.7B 全模态家族,4-bit 仅占 1GB 却主动劝退复杂推理
Liquid AI 于 2026 年 10 月 27 日推出 2B 级别的 LFM3 基础模型家族,涵盖文本、视觉、音频、全模态及校准回答共 6 款模型。尽管官方主打 4-bit 下约 1GB 体积与 256K 上下文,但模型卡明确劝退复杂推理与编程,且多模态上下文大幅缩水,说明它并非端侧全能小钢炮,而是依赖单卡微调的垂直任务底座。
OpenAI 与 Oracle 扩大合作推 AI Workspace,送 1.2 万美元额度抢 ERP 入口
OpenAI 与 Oracle 于 2026 年 10 月 27 日宣布将 Fusion、NetSuite 等核心企业应用接入 ChatGPT,并推出包含每年 1.2 万美元云额度的中小企业套餐。相比尚未定档的四款新产品,真正致命的商业杀招是允许美国企业直接用 Oracle 预付通用额度采购 OpenAI 全家桶,绕开繁琐的新增预算审批,在微软与 Salesforce 之外撕开企业后台入口。
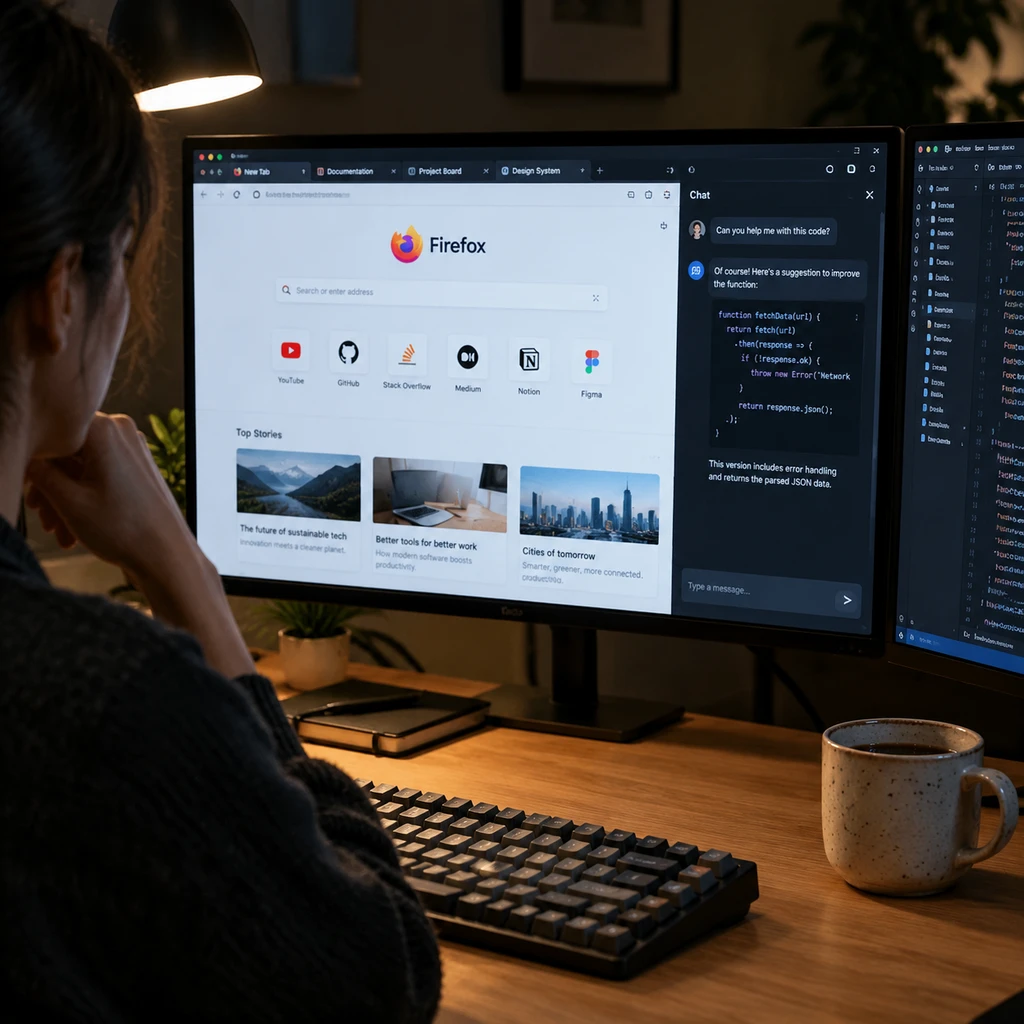
Firefox 150 上线 Smart Window:Gemini 3.1 填表、Qwen 盯网页背后的隐私妥协
Mozilla 在 Firefox 150 的 Smart Window 测试版中免费推出跨标签页填表和网页监控功能,正面对标收费 $19.99/月起的 Chrome 与 Perplexity。但拆开底层路由会发现,哪怕用户配置了自定义模型,填表和监控仍会强制发往 Google Gemini 3.1 Flash Lite 与阿里 Qwen,揭开了独立浏览器在 AI 时代的信任边界悖论。
Google 发布 Genie 4 世界模型,2 分钟实时模拟背后藏着 7.84 美元一局的账单
2026年10月27日,Google DeepMind 发布世界模型 Genie 4 研究预览版,新增实时音频生成与文本实时操控,场景一致性延长至两分钟。但相比前代与竞品 Runway GWM Worlds 2,Google 罕见隐去了分辨率与帧率参数;其主打的机器人仿真演示实为文本提示词驱动的视觉渲染,距离真正的物理控制还有巨大的精度与成本鸿沟。
Ai2实测GPT-5.4与Claude Opus 4.6,改提示词让科研新颖性准确率暴跌52.6%
艾伦人工智能研究所(Ai2)发布基准测试,评估GPT-5.4、Claude Opus 4.6等6款大模型评判科研点子新颖性的能力。结果显示,提问方式从揣摩审稿人改为直接判断原创性,会让GPT-5.4准确率从93.5%暴跌至40.9%,且耗资82美元的专用评估系统表现不如2.59美元的简单提示基线。大模型目前更擅长迎合学术审稿品味,而非识别真正的科学未知。