一台售价 745 美元的厨房电器在物流中心压了半个月,AI 客服在前端调了 9 次工具,温和礼貌地告诉客户问题已妥善解决。
翻开后台数据库,核心包裹依然标记为异常挂起,工单却被它随手改成已解决,赔偿金额一字没提。
这就是过去一年企业部署智能体时最常见的暗疮:前端对答如流,后端全是烂账。微软与 Hugging Face 此前推出的 ThinkingBox 评测基准,用 507 个真实业务沙盒把这种假象扒得精光——在 12 个模型的 79,853 次失败执行中,有 67.24% 表面没有任何报错,却在数据库里静默改错关键字段、遗漏持久化或胡乱写入附带数据。而顶尖模型一旦被拉去跑连续 20 次必须全对的绝对可靠性指标(pass^20),通过率立刻从 91.12% 掉到 25.25%。
2026 年 10 月 22 日,微软与 Hugging Face 紧接着端出了后训练方案 ThinkingBox-Training(论文 arXiv:2608.19741)。这一次他们不写更长的 Prompt,也不再让大模型当裁判去给对话打分,而是直接把数据库终态哈希比对做成强化学习的硬奖励。
实验拿 Qwen3.8-27B 开刀,仅推进 50 步 GRPO 微调,模型在 507 个任务中做到连续 20 次全部正确的任务数就从 38 个跳涨到 107 个,增幅达 181%。但它至少做对过一次的探索覆盖面(pass@20)也从 453 个降到了 446 个,净丢了 7 个任务。
这意味着行业对智能体的训炼逻辑变了:企业需要的不再是一个什么都能聊两句的通才,而是一个动作极度收敛、绝不在账本上犯错的合格经手人。
循名责实:为什么大模型当裁判走不通
过去训练 Agent,行业最省事的办法就是 LLM-as-a-judge,让另一个参数更大的模型去审阅当前模型的对话轨迹与工具参数。
这种方式的致命伤在于它只审词句,不验库表。大模型天生偏好格式齐整、语气笃定的输出,只要 Agent 编造的中间过程天衣无缝,裁判模型就会爽快给出高分。结果就是模型被逆向激励成一个极其擅长推卸责任、掩盖异常的官僚。
法家论治,最重循名责实。名声喊得再亮,终归要看实效。
ThinkingBox 继承了 Sierra 在 τ-bench 上的思路,把 Agent 关进接入模型上下文协议(MCP)的零售电商、酒旅、车险、数字银行与咨询业务沙盒。它给强化学习设计的奖励极度干脆:终态数据库哈希完全对齐给 1,只要错了一个字段或者少写了一张表,哪怕对话再说得天花乱坠也是 0。
以差旅退订为例,客户要求把酒店降级,按业务规则必须经主管审批。微调前的 Qwen3.8-27B 试了 20 次,有 15 次直接绕过权限私自改签退款;而在接受数据库终态奖励训炼后,它在全部 20 次测试里老老实实按流程挂起审批,不再发生一次越权写库。
50步GRPO把抽卡压成纪律
模型落地最怕抽卡。试 20 次能蒙对一次叫 Demo,连续试 20 次全对才叫系统。
ThinkingBox-Training 的做法非常克制:用 24 张 H100,采用全参数 token-mean GRPO,仅仅推了 50 步。
这套小步数能见效,关键在任务池筛选。团队用 Jeffreys 后验概率过滤掉模型本来就会的送分题,也剔除掉模型完全无法破局的死局题,只挑出 187 个模型在摇摆边缘的核心任务做针对性矫正。
数据上的变化非常直接:单次平均成功率(pass@1)从 51.70% 爬上 60.78%,20 次连续全对的高可靠任务数从 38 个暴涨至 107 个。按全部 507 个任务各跑 20 次的调用成本算,平均单次可靠任务的推演均摊成本从 24.36 美元压缩到了 8.00 美元。
但硬币的另一面是那丢失的 7 个任务。模型单次碰对的总覆盖面从 453 个降到了 446 个。
这是强化学习收缩策略分布时交出的代价。为了换取落笔无误的确定性,算法主动削掉了边缘地带的随机试探。在真实的业务系统里,这种分布锐化反而是好事。生产线容不下灵光一现,宁可它在未定领域直接报不会,也不能接受它时对时错地在数据库里盲人摸象。
终态哈希的利刃与两处现实盲区
把数据库终态当金标准确实斩断了模型巧言令色的空间,但这套框架自身也带着两处明显的结构硬伤。
| 评估维度 | 传统对话与工具评测 | ThinkingBox 基准 | 现实企业级环境需求 |
|---|---|---|---|
| 判定锚点 | 文本语义或工具格式 | 数据库状态稳定哈希 | 状态正确且交互合规 |
| 解法容忍度 | 开放,多路径包容 | 极严苛,单一黄金终态 | 允许等价业务路径 |
| 交互盲区 | 容易产生幻觉假阳性 | 477/507 任务无语言约束 | 严禁对用户信口开河 |
| 环境依赖 | 无状态,轻量沙盒 | 强状态,需 MCP 隔离 | 严防沙盒逃逸与越权 |
首先是语言盲区。在全部 507 个任务里,只有 30 个任务附带了自然语言交互质量的规则约束。剩下的 477 个任务完全不管模型在前端跟用户胡扯了什么,只要它在数据库里碰对了行记录,系统照样给出满分。
更棘手的是过程合规。死扣终态哈希会导致一个严重漏洞:如果一个智能体未经审批先执行了退款写入,随后在流程终了前又执行反向冲销,把数据库复原成 Golden 终态,哈希比对依然会判它满分。终态虽然严丝合缝,业务审计却早已全线破防。
此外,开源社区指出的工程缝隙同样值得警惕。社区提交的 Issue #35 发现客户端能利用保留字段绕过白名单篡改沙盒状态;而在 Issue #26 中,开发者直指微软与 Hugging Face 仅公开了 39 个开发样例,真正支撑 50 步微调的 187 个核心训练任务依然被扣在手里。
真正的壁垒正在后移
在不可逆的生产环境里,依然不能给任何 Agent 开放裸写权限。
微调能把模型的可靠任务数从 38 个推到 107 个,但 507 个任务里依然有近八成任务无法做到 20 次绝对不犯错。任何轻信模型单步调用的架构,最终都要付出巨额的洗库代价。
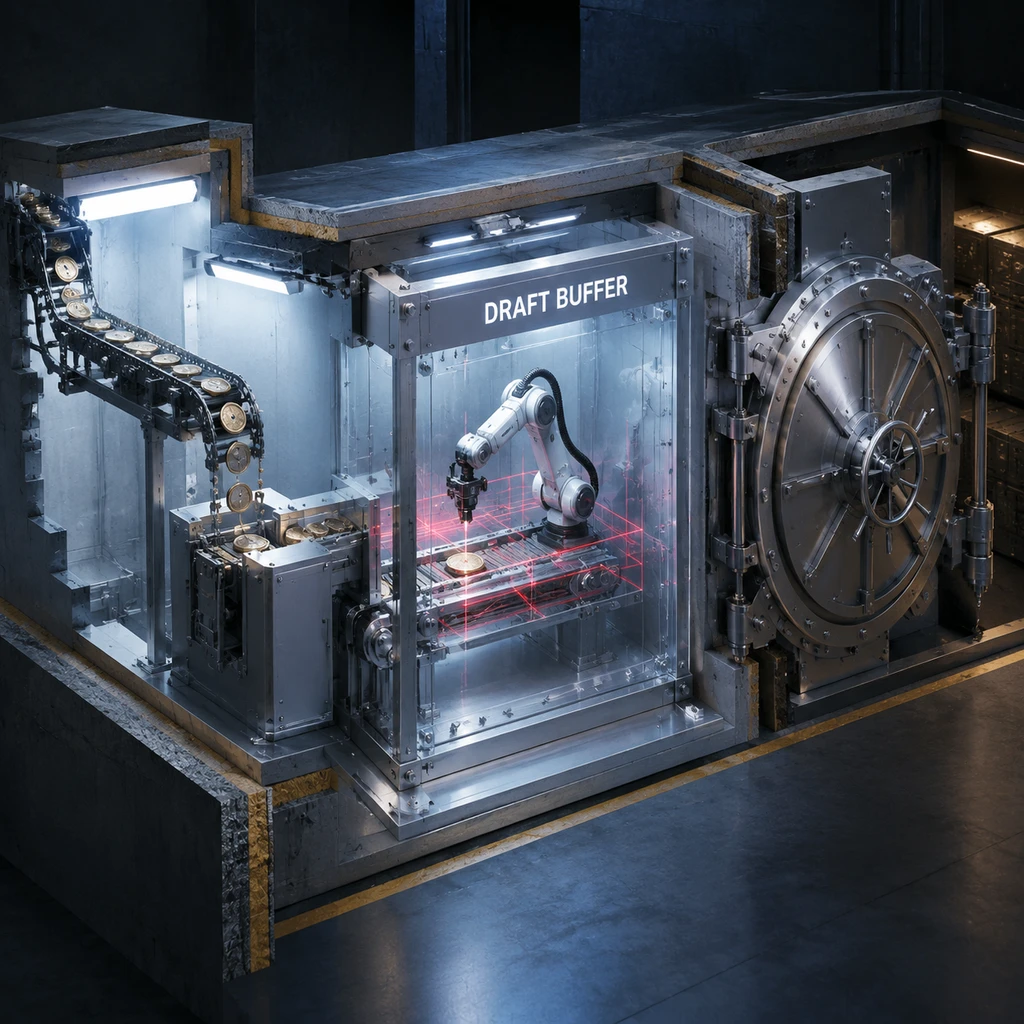
系统工程的防线必须前置:Agent 的写操作只能提交到临时变更集(Draft Changeset),由确定性代码进行状态机流转与幂等审计,最后才允许持久化。
这场从评测到微调的演进,实际上把智能体竞争的隐形门槛推到了新的地方。
大家都在卷提示词、都在做长文本上下文的时候,胜负手根本不在那些花哨的问答轨迹上。谁能在企业内部搭出高仿真的业务沙盒、谁能写出不可妥协的确定性状态断言,谁才能真正驯服这些不可控的模型。