为了让大模型在五个分类工单里选一个,或者判断质检照片是否合格,很多团队一直在忍受荒唐的工程代价。系统必须跑完一整套自回归解码循环,按输出 token 付钱,再战战兢兢地解析随时可能少了个逗号的 JSON 字符串。
工业控制和边缘网关不需要会写长文的聊天助手,只需要毫秒级落地的确定性开关。Liquid AI 在 2026 年 10 月 7 日开源了端侧多模态决策模型 d1 家族,拔掉文本生成头,单次前向直出结果;紧接着在 10 月 15 日,他们又正式上线了闭源旗舰版 d1-ultra,不仅在 Artificial Analysis 刚出炉的决策榜单拿下 65 分登顶,更打出每百万输入 Token 仅 0.042 美元的极低报价。
把生成模型改造成只给判断的判别网络,看似是用奥卡姆剃刀割除了大模型的虚火。但在极速反应与低廉标价背后,多模态输入的强行阉割、多提问场景下的账单乘数陷阱,暴露出这种架构极难回避的工程代价。
撕开自回归的边缘开关
d1 追求的不是长篇大论,而是把分类概率直接映射出来。从端侧的 d1-3B 到云端托管的 d1-ultra,它们只输出三种类型化结果:判别是非的布尔值、选择具名标签的选项分布,以及输出期望等级的数值评分。
单次前向传播砍掉了逐字读写显存的开销。在桌面显卡 RTX 4090 上,d1-3B 的单问题时延被压缩至 8 毫秒;在 AMD MI325X 上为 9 毫秒。放在低功耗嵌入式板卡上同样迅速:Jetson AGX Thor 为 16 毫秒,Orin 64GB 为 26 毫秒,即便是最小的 Orin Nano 也只要 50 毫秒。
对需要挤进 10Hz 控制闭环的具身机械臂与工厂闸机而言,50 毫秒以内的本地时延确实具备杀伤力。但早先传闻的端侧免费云接口并不存在,开源的 d1-3B 仅以权重形式挂在 Hugging Face,必须由开发者自备算力;真正提供托管调用的,是按 Token 计费的商业闭源模型 d1-ultra。
零输出绝非全额免单。它省掉的只是解码生成过程,文本预填充、多模态图像编码与音频特征抽取,该耗的算力一分都不会少。
跑分滤镜与多提问账单陷阱
在 Artificial Analysis 新立的 Decision Index 基准中,d1-ultra 拿到了 65 分,越过 TypeSafe Jev 1.13 的 58 分与微软同类模型的 54 分。
| 核心指标 / 限制 | d1-3B (开源端侧主力) | d1-ultra (商业闭源托管) | d1-omni-600M (开源实验版) |
|---|---|---|---|
| 物理参数量 / 交付形式 | 3.12B / 开源权重 | 未披露 / 闭源托管 API | 587M / 开源权重 |
| 模态支持形式 | 文本 + 图像 | 文本 + 图像 | 文本 + 图像 或 文本 + 音频 (互斥) |
| 上下文 / 限制 | 32,768 tokens 全长 | 最大 8 图 / 10,000 patches | 图像截断至 896 tokens / 音频限 30 秒 |
| 决策基准总分 (Decision Index) | 48.57 分 | 65 分 (厂商自测) | 15.95 分 (几乎不可用) |
| 调用成本 | 硬件自备 | $0.042 / 1M input tokens | 硬件自备 |
d1-ultra 报出的每百万输入 Token 0.042 美元看似低廉,甚至远低于微软模型每百万次任务 31 美元的基线。但真正的账单陷阱埋在多模态与批量判断的计费公式里。
在图像处理端,d1-ultra 按每 32×32 像素计为 1.5 个 Token,一张标准的 1024×1024 图像直接吃掉 1,536 个 Token。该接口虽然允许在单次网络请求中传入多个提问,但内部计费逻辑会把每个问题当成独立 Prompt 重复计算。
单次请求最多承载 8 张图片、10,000 个 patch。一旦在单张图片上追加 3 个质检判断题,整张图片的 1,536 个 Token 就会被乘以 3 次全额计费。极低的输入单价,在复合业务面前会被这种乘数瞬间吞噬。
不仅商业端如此,开源版本的成色同样割裂。在 11 个公开图像基准中,d1-3B 平均分仅为 74.1,对比基座 LFM2.5-VL-3B 的 73.9 只涨了 0.2 分。至于 587M 的 d1-omni-600M,在 Decision Index 上仅拿到 15.95 分,模态互斥且强行截断,显然只是仓促放出的早期检查点。
泛化雪崩与盲目自信的数学隐患
比起计费乘数,更致命的危险潜伏在数学层面。自回归模型虽然臃肿,但在逐字解码时隐式更新注意力,能依靠较长的推理步骤缓冲逻辑偏差;单次前向模型只走一步就必须敲定输出,剥离了一切自省和回溯的余地。
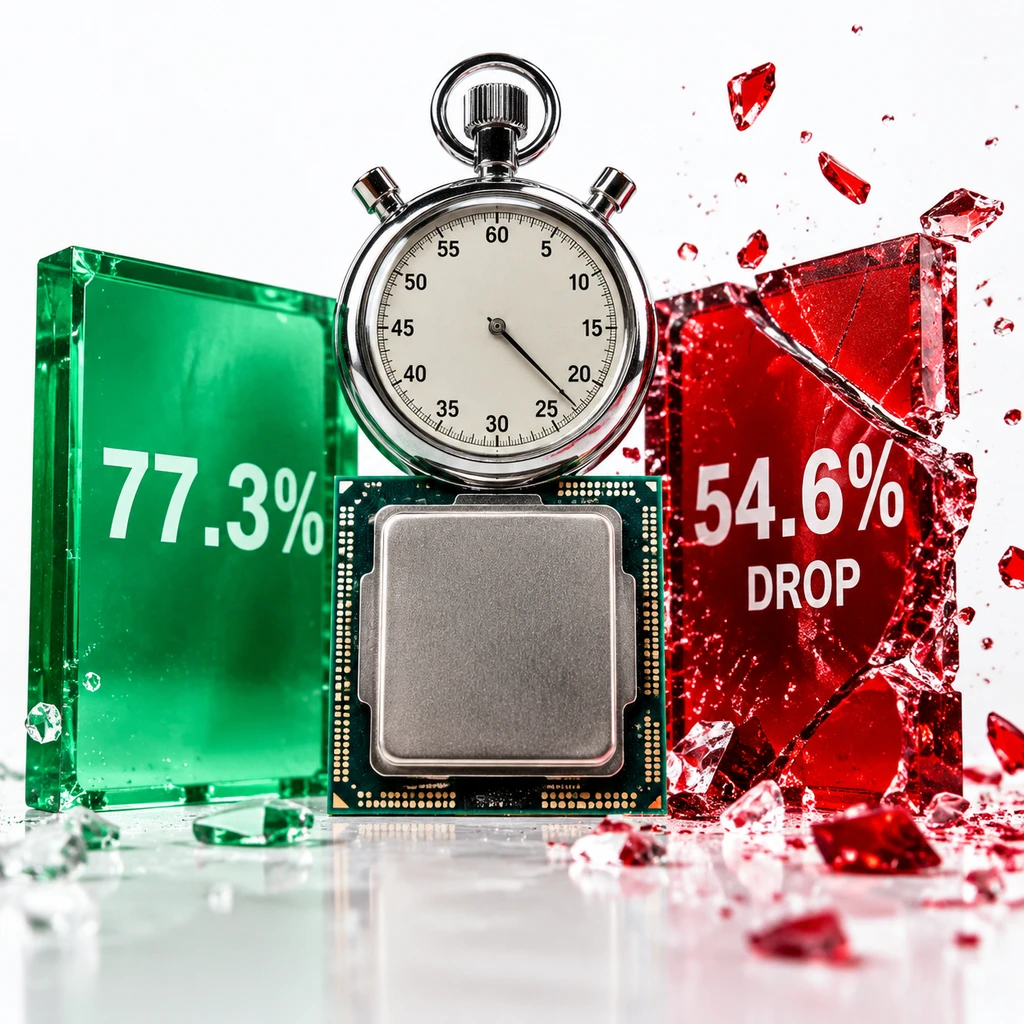
对该架构原型的实测揭示了惨淡的泛化落差。在域内测试中能拿到 77.3% 准确率的模型,一旦扔进未见过的域外分布,准确率会断崖式暴跌至 54.6%。面对生产现场从未标注过的异常工况,模型的裁决基本等同于抛硬币。
雪上加霜的是预期校准误差。单次前向输出的 softmax 分布只是数学上的相对比率,不能等同于现实概率。同类竞品在 Banking77 任务上的校准误差扩大到了 0.098,在毫无先验信息的测试中,依然会极其自信地输出超过 0.9 的高分。
质检系统若将 0.95 当作 95% 的通过把握,遇到未知形变的残次零件,系统会在毫无察觉的高确信状态下一路放行。
选项死线与旧技术的借尸还魂
分类头与指针网络带来的另一个物理约束是选项硬上限。动态输入的候选标签一旦超出模型预设容量,系统不会像通用大模型那样在长上下文里慢慢处理,而是直接抛出越界异常拒绝服务。
技术演进并非只有一种范式。《韩非子》尝言:「长袖善舞,多钱善贾。」然而在边缘计算与工业网关的现场,算力从来不是可以挥霍的长袖,而是捉襟见肘的功耗与显存。剥掉自回归机制确实能换来极速,但这绝非万能解药。
开发者在不同任务面前,始终面对着三套完全不同的工程账本:
| 架构形态 | 吞吐与延迟 | 选项扩展能力 | 维护与校准成本 |
|---|---|---|---|
| 传统专用编码器 (ModernBERT / DeBERTa) | 毫秒级极速响应 | 极差(仅限写死预设标签) | 极低(权重微小、行为确定) |
| 通用自回归大模型 (JSON 解码) | 缓慢且重载显存 | 极强(支持数百个动态长尾项) | 较高(需防范格式崩溃与延迟) |
| 新型决策模型 (d1-3B / d1-ultra / Jev) | 百毫秒内单次遍历 | 中等(动态支持但有硬上限) | 极高(需自建 ECE 置信度校验与多问账单核算) |
如果业务面对的是固定标签的工单初筛,百兆参数的 ModernBERT 几年前就能在 CPU 上跑出极低延迟,根本用不着 3B 规模的模型;如果任务充满未知的开放世界上下文,需要逐步调用工具与容错排查,通用的自回归模型依然是唯一的安全兜底。
从开源的 d1-3B 到商业化的 d1-ultra,Liquid AI 试图在自回归的庞大帝国上凿开一道口子。把单次直出模型当作低成本的前置安全哨兵或协议分流器是合理的,但若指望它在缺乏校验机制的情况下直接接管工业闭环,或是被极低单价吸引而忽略了多模态提问的乘数账单,速度再快,算错也是徒劳。