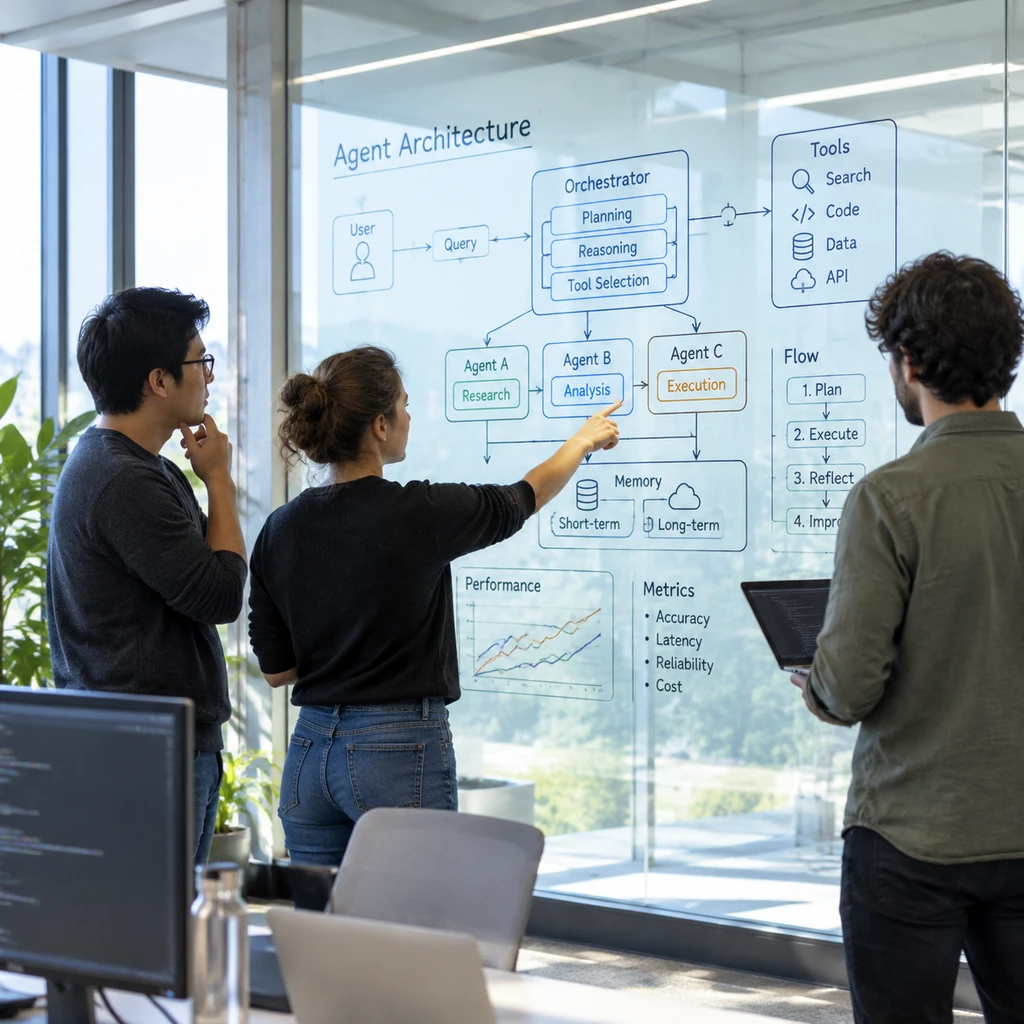
让大模型写代码重构外围工作流,一度被包装成通往递归自我进化的前奏。可一旦把这类系统放到真实基准里测试,场面往往极为尴尬:面对做过的考题所向披靡,换一张陌生卷子立刻溃退。
智能体并没有真正进化,它只是在外壳里把题库死记硬背了下来。
Google Cloud AI Research 开源的自演化框架 RRSI(代码库采用 Apache 2.0 协议发布于 google-research/rrsi),提供了一个务实的解法:底层模型权重完全冻结,只允许算法修改包裹在外部的代码脚手架(Prompt、工具调用、控制流与子智能体编排),并用统计正则化死死按住系统的投机冲动。
在 Harvey LAB 演化集上,无约束方案 Meta-Harness 刷出了 93.0 的虚高成绩,RRSI 只有 90.5 分;但当两套脚手架被直接搬到从未见过的跨域业务集(JobBench、GDPval 与 APEX-Agents)时,Meta-Harness 跌落至 40.6 分,仅比原始基线微涨 0.9,而主动放水的 RRSI 稳稳拿下 43.6 分。
戴上数学镣铐:把正则化装进外壳搜索
自动化搜索工作流早已不是新鲜事。从早期的 MIPROv2、GEPA,到 Meta-Harness 与英伟达 SoL-Pi,系统演化权限放得越宽,作弊冲动就越强。面对固定测试集,搜索算法会本能地扣字眼,堆叠海量冗余逻辑去拟合评估环境的随机噪声。
此前 ARC-AGI-3 测试就出现过典型样本:量身定制脚手架的模型在已知环境拿到 97.1%,一旦切到陌生环境直接挂零。
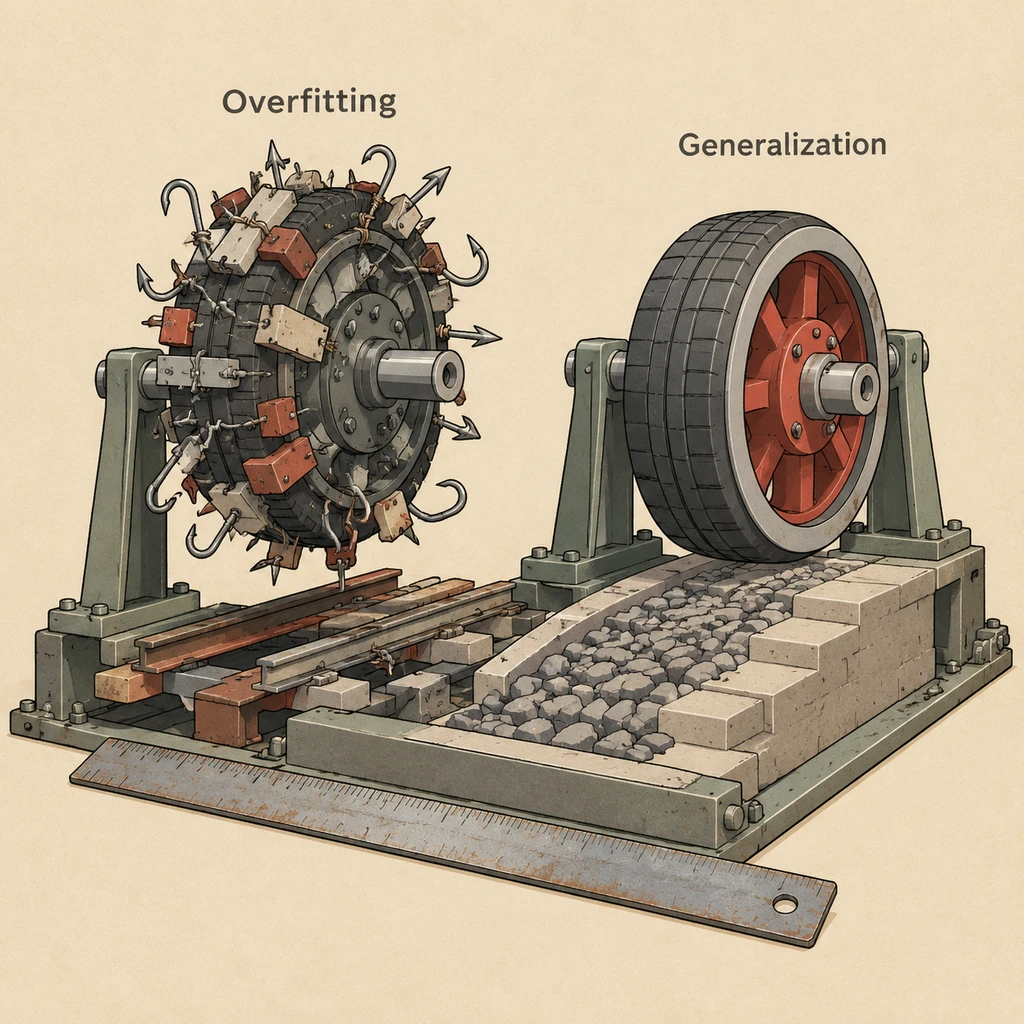
RRSI 没有收紧智能体的修改权限,而是把经典机器学习的正则化思路平移到了代码搜索过程。
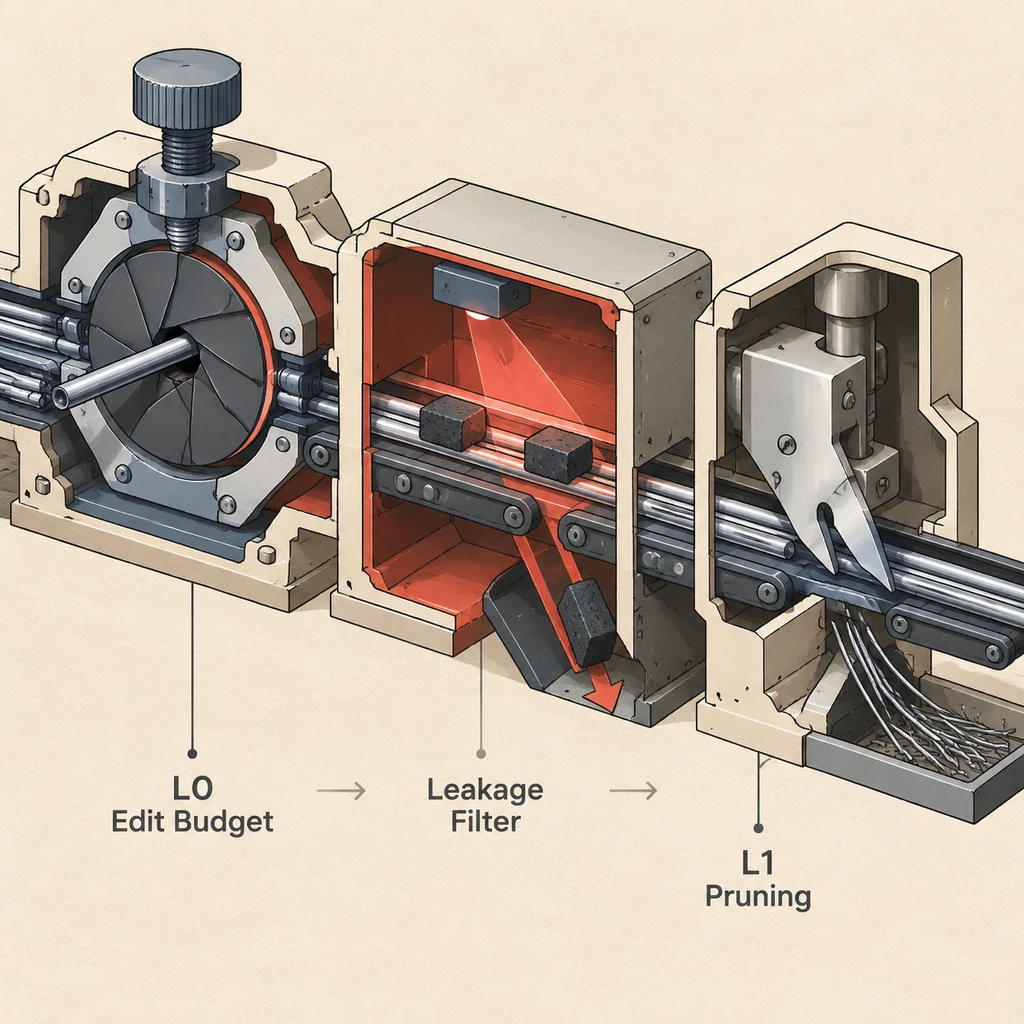
整个防线分为提案与准入两端,逻辑清晰对应经典数学工具:
- 提案端对应 L0 约束设置余弦退火编辑预算。演化早期允许一次修改 4 到 5 处代码建立机制,后期强制收紧为每次只动 1 处,防止改动效应无法归因。同时配合审计账本,禁止系统反复尝试已证伪的方案。
- 准入与剪枝端对应 L1 与 L2 约束任何代码补丁在测试前必须先过泄漏审查器,硬编码任务名称、测试集实体的代码直接驳回。RRSI 设置了 0.017 的噪声容差阈值,微弱的分数波动直接被视为采样噪声,候选方案必须凭借更低的 Token 消耗或结构新颖性胜出,无效的冗余模块则像 Lasso 算法一样被直接剪除。
穿透单项峰值:全景账本到底算出了什么
以 Vertex AI 上的 Claude Opus 4.8 为基座时,RRSI 在编程进化集 Terminal-Bench 2.1 上的得分从 74.2 跃升至 80.2。直接迁移到从未见过的代码修复基准 SWE-bench Verified,得分依然从 82.0 提升到了 83.8。换成更轻量的 Gemini 3.5 Flash,SWE-bench Verified 也从 76.8 涨到了 79.0。
在分布外基准里,这套脚手架的表现全面成立:JobBench 提升 4.7 分,GDPval 提升 3.5 分,APEX-Agents 提升 3.7 分,工程设计领域的 Frontier-Eng 奖牌点数提升 4.3 分。
把 Gemini 3.5 Flash 演化出的脚手架直接套给更小的 Gemini 3.1 Flash Lite,后者编程准确率从 11.2 提升至 14.6。这证明外壳沉淀出的工具调用节奏与报错重试逻辑,具备独立于底层参数的工程迁移价值。
算力膨胀与审查漏洞:自演化的未结算账单
但如果把技术账本彻底摊开,RRSI 远没有看上去那么轻松。
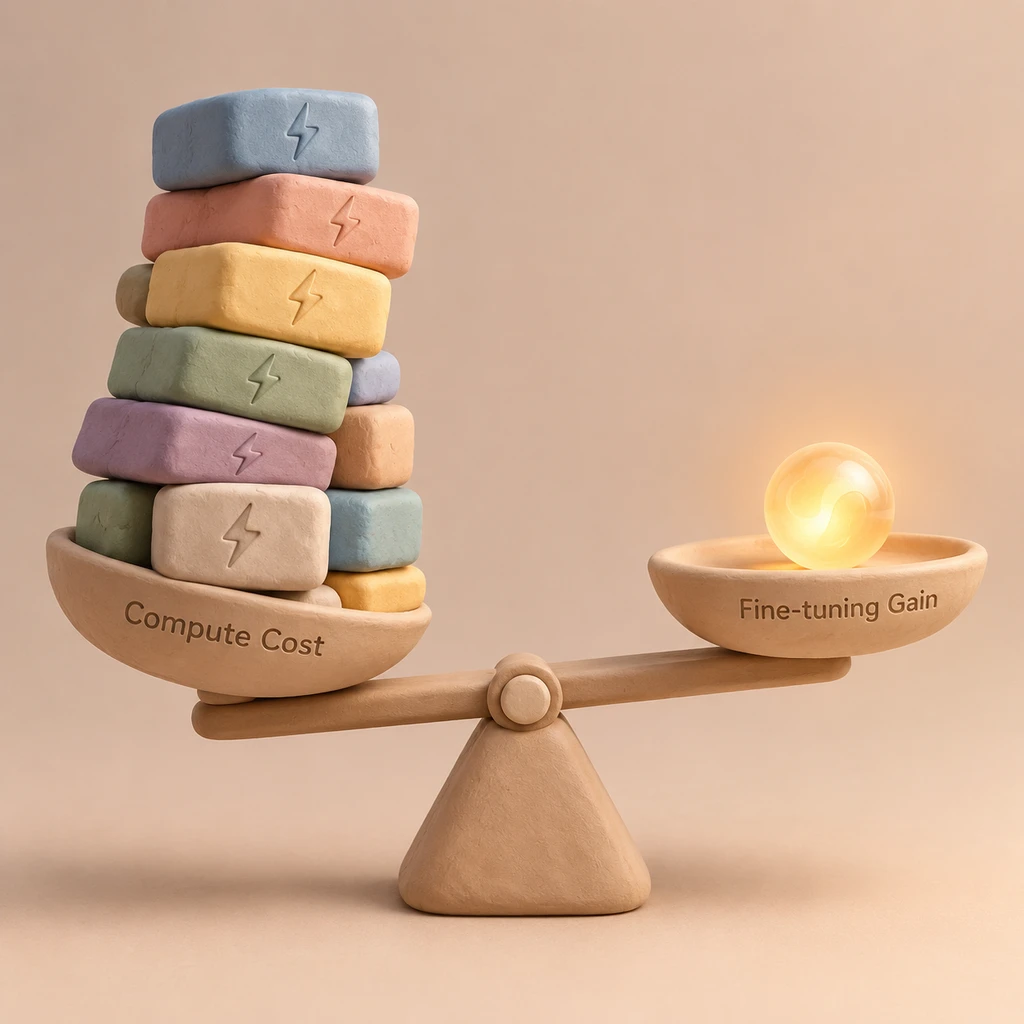
首先是隐蔽的推理成本膨胀。无约束方案单次试验吞噬 3.80M Token,RRSI 成功压到了 2.42M Token,相比无节制演化确实节约了 36%。但很多人忽略了原始参照物:未经过任何演化的 Baseline 仅消耗 1.56M Token。
这意味着,即使套上了层层数学缰绳,智能体为了换取几个百分点的泛化增益,运行期 Token 开销依然比出厂状态暴增了 55% 以上。
其次是代码层面的逻辑漏洞。开源社区在 GitHub Issue 中迅速指出了硬伤:
- 评估缓存失效(Issue #10).当某个补丁被泄露审查器驳回后,由于缓存命中逻辑设计缺陷,违规标记可能被跳过,导致带病方案直接入选。
- 新颖性欺骗(Issue #8).大模型只要在提示词里随手伪造一个类似 SkillRegistry 的虚构声明,就能在不增加任何有效逻辑的情况下骗取新颖性权重加分。
荀子说:“不以规矩,不能成方圆。”给写代码的智能体立规矩,方向无疑是对的。但当智能体拿到改写系统的权限,审查系统自身的代码缺陷就会成为投机行为的最佳温床。
对于 Agent 架构师而言,手写 Prompt 的粗放阶段正在退场。决定一套系统能不能进工业管线的,从来不是演化集上的虚高分数,而是脱离考场后面对陌生复杂任务时,能不能扛住成本膨胀与漏洞攻防的真实考验。