人工智能资讯 第76页
聚合当前分类下的最新内容,按时间顺序查看第 76 页精选文章。
这份招聘启事,是一份产品成熟度自白书
Tasklet以30万至45万美元年薪招募一名身兼产品、设计、全栈工程三重角色的IC,表面是抢人才,实质是公开承认:AI agent真正落地企业场景最难的那一环——权限、报错、人机交接、可撤回性——公司内部尚无playbook。结合第三方披露的计费争议和SOC 2认证时间线矛盾,Tasklet在'trustworthy'这个自我定位上,承诺与现实之间的落差比招聘文案更值得细读。
Anthropic公开Claude系统提示更新史,但API用户一个字都看不到
Anthropic在文档里公开了Claude网页版和App系统提示的历次修改时间,明确不涉及API,这在行业里算少见的透明动作。但公开提示词文本本身不等于系统更安全,安全研究界的数据显示,藏起来的指令大概率能被套出来。
只读到五年级的语言模型,能否推理出六年级知识?答案取决于怎么测
把语言模型的训练材料限制在五年级以内,可以检验它究竟在重组记忆,还是能把已有规则外推到陌生问题。但现有线索没有给出论文、数据集和实验分数,因此“模型永远学不会六年级”仍是未经证实的强结论。真正有价值的观察点,是语料边界、对照实验和后训练过程能否经得起核查。
AI写代码跨过了门槛,但“它不会推理”的证据没那么硬
一篇软件工程博客称agentic编程工具已越过“能不能做到”的门槛,真正的坎是接口设计、可维护性这些人类经验活;但它援引的“LLM不会推理”核心论据——苹果那篇论文,本身正被学界质疑存在评测缺陷。工程基本功更重要的判断大概率仍然成立,只是论证链条比想象中更脆弱。
只剩几分头部空间,可能是基准尺子先坏了
独立项目Benchmark Radar统计了32份frontier model card对79个基准的报告情况,发现Arena-Hard只剩4.4分头部空间,MATH-500只剩2分,DeepSeek一款模型26天内在AIME上涨了40.6分。但对照学界对这些基准饱和度、训练数据污染和小样本噪声的研究,这些'逼近极限'的信号更像是尺子钝了,而不是模型到顶。
扮演AI聊天机器人60秒:一款免费小游戏戳中了公众的AI疲劳
The Verge一篇讲“扮演AI自嘲AI”的报道正文意外丢失,只剩导航栏,但真正的主角其实是免费网页游戏《Your AI Slop Bores Me》:真人限时假扮聊天机器人回答陌生人的请求。它和一款同名撞车的日本Steam游戏内核完全不同,前者的走红更值得留意——它精准踩中了2026年公众对AI生成内容的集体审美疲劳。
AI制药的成绩单:早期漂亮,Phase II原地踏步
《Nature Reviews Drug Discovery》最新综述指出,AI制药在临床层面的证据仍然'令人失望地有限',关键考验Phase II尚未看到实质突破。拆开具体数字会发现:AI药物Phase I成功率明显高于历史水平,但Phase II成功率与行业基准大致持平,且样本太小、缺乏同期对照,还撑不起因果结论。
Claude水印说明书:Anthropic自曝“全篇重写即失效”
Anthropic在8月15日详解了Claude文本水印的技术细节,承认整篇重写足以让水印失效,这暴露出欧盟透明度监管的技术天花板。放在行业里看,Google才是这项技术的原创方且已在Gemini落地,OpenAI在文本层面至今没有对等承诺,Anthropic更像是被法规推着交作业的一方。
上下文拉到128K,Gemini数学准确率反而跌到51%
一篇热议博客提出假说:AI数学表现变强,靠的是远超人脑的外部工作记忆,而非更聪明。但MathHay等基准测试显示上下文越长准确率反而下降,GSM-Symbolic更发现一句无关的话就能让准确率暴跌,说明记忆容量大只是必要条件,不是充分条件。
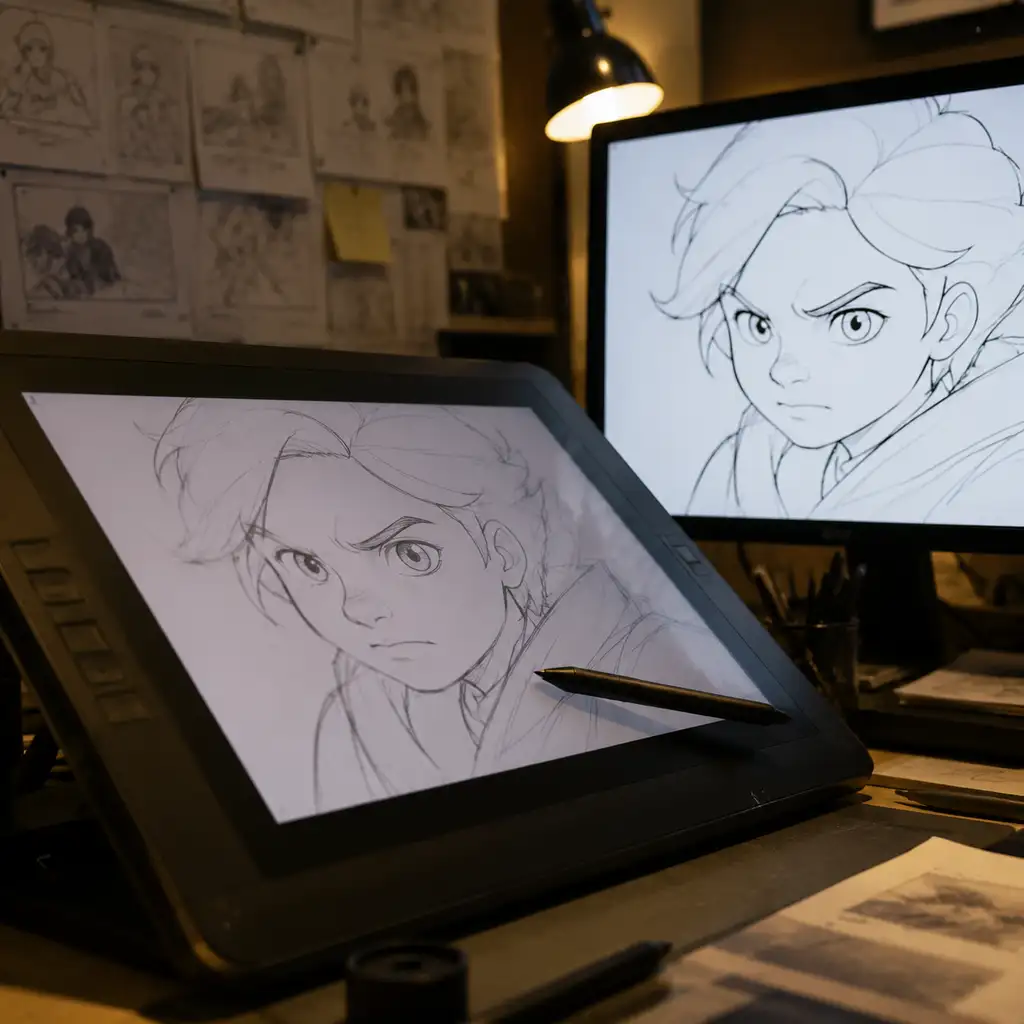
迪士尼教AI拆线稿,画师的笔还得自己拿
迪士尼研究院公布一套线稿矢量化方法,用深度和语义模型拆解笔画骨架,联合Bézier曲线与2D Gaussian Splatting做可微拟合,还试着扩展到视频跟踪。论文自称重建效果达到state-of-the-art,但没给具体指标和基线对比,视频结果也只是初步尝试。真正值得注意的是,拟合结果留了给画师改样条的接口——这说明团队清楚,全自动化这条路目前走不通。
程序员觉得AI让自己快了20%,METR实测却是慢了19%
METR的一项对照实验发现,经验丰富的开发者用AI辅助编程,任务耗时反而增加19%,但他们事后依然认为自己快了20%。与此同时,OpenAI证实被广泛引用的SWE-bench Verified基准已被污染,厂商刷榜的分数并不可比。体感和榜单这两把常被拿来判断AI编程价值的尺子,眼下都不太可信。
302选16:斯坦福让AI设计的病毒基因组第一次真的能跑
斯坦福团队用基因组语言模型Evo 2生成302个噬菌体候选基因组,最终只有16个成为能感染实验室大肠杆菌的活病毒,成功率约5%。独立分析显示这些成品仍落在已知ΦX174家族的多样性范围内,更像系统性搜索演化没走过的组合,而非凭空造出新病毒。对噬菌体疗法研发者来说这值得跟踪,但离临床采购还差审批路径、动物实验和成本下降。
“像带团队一样用AI”走红之后,出了错谁负责?
一篇个人博客提出,与AI协作更像领导团队而非操作代码,这一比喻在任务分解和迭代评审层面确实成立,但一旦涉及代码溯源和问责,就撞上了开发者社区正在真实经历的裂缝。斯坦福的研究和Hacker News的争论都指向同一个问题:流畅的“协作感”不等于可靠的责任链条。
Netflix新推荐系统:线上只涨0.006%,标注数据却少用了40倍
Netflix用大模型改造推荐系统,内部测试显示离线排序指标涨1.6%,线上核心指标只涨0.006%,但标注数据用量减少了40倍。这不是一次效果突破,更像一次刻意避开自回归生成陷阱的降本工程。
232倍加速却排第12:Codex赢不过换算法的冠军
Sankalp用Codex在GPU Mode的qr_v2赛题上14天提交1500次,跑出相对baseline约232倍的加速,最终排名12/183;但夺冠选手换了一套CholeskyQR混合算法,跑分反而比他快近48%,说明当前AI agent更擅长在既定算法框架里高强度搜索参数,真正的算法路线突破仍然要靠人。
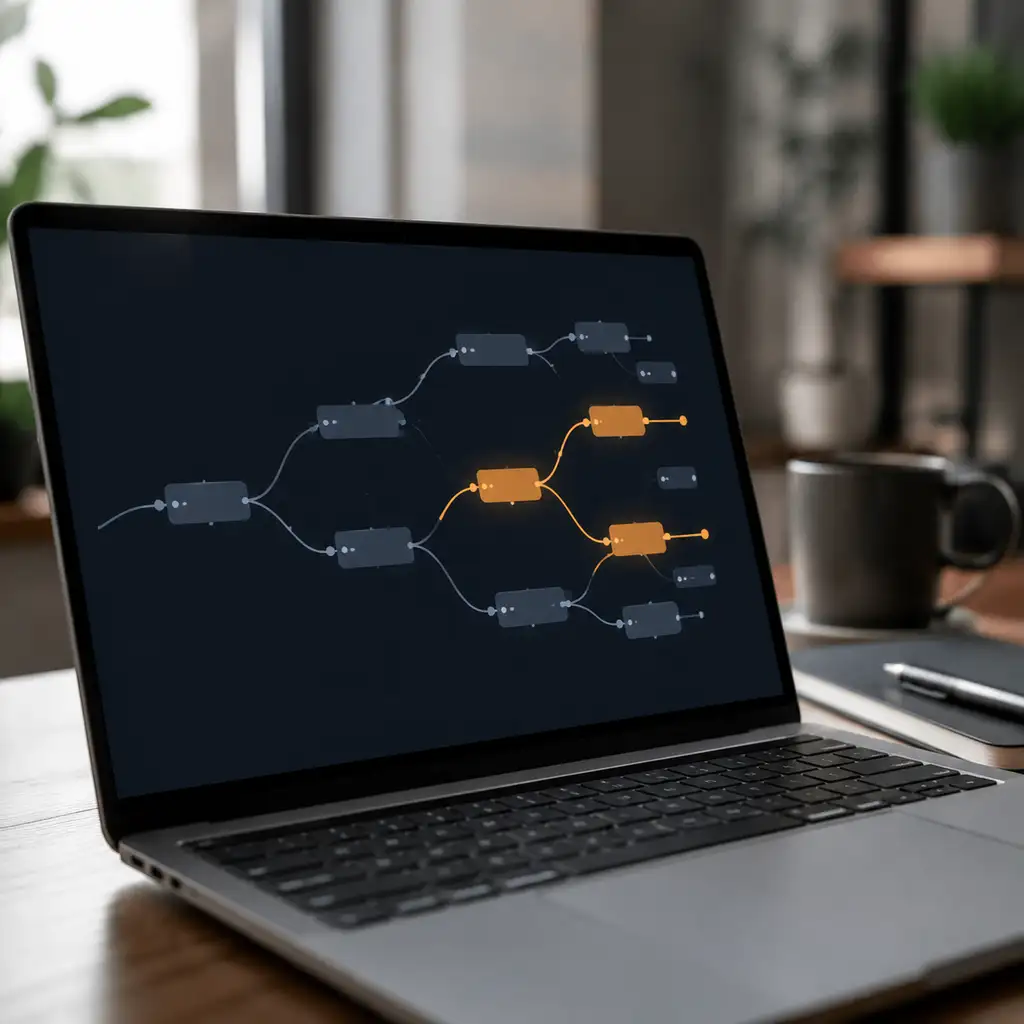
删掉一条连线,AI答案就变了:ThoughtDAG想让上下文不再靠猜
开源工具ThoughtDAG把AI对话变成一张可编辑的有向图,删掉一条无关连线就能让污染的回答变干净,但同类思路已经挤进至少五个创业项目和两篇学术论文,它的真正考题是能否把图从导航界面升级成决定生成结果的执行系统。
白宫喊话改革美国科研,预算申请先砍了基础研究四成
《经济学人》刊出白宫科技政策办公室科学总管Kratsios的署名文章,呼吁大改美国科研体系,主打AI与对华竞争。文章正文因付费墙未能读全,但同期FY2026预算申请显示,NIH、NSF、NASA科学项目降幅普遍在四到五成,DARPA几乎未动。改革的名义之下,数字暴露的是对开放式基础研究的选择性收缩。
1856个标签喂不进AI,有人干脆让它先胡编
Simon Willison转发了Doug Turnbull的一个分类技巧:标签库太大塞不进prompt时,别喂真实标签,让模型先凭空想象出分类,再用向量检索去匹配语料库里最接近的真实标签。这招和学术界的HyDE方法思路几乎一样,但目前没有任何公开数据能证明它比传统方案更准。
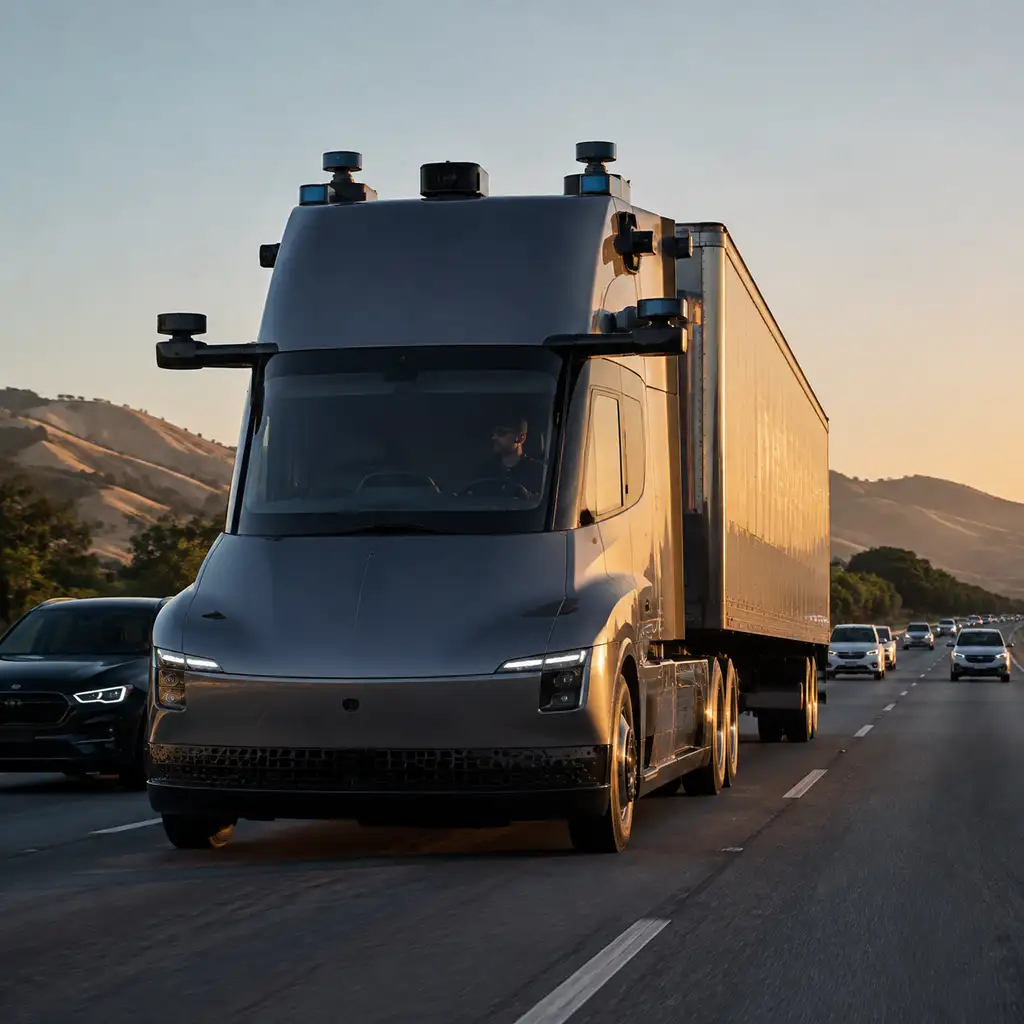
加州放行自动驾驶重卡,方向盘后还得坐个人
加州DMV解除万磅以上无人车路测禁令,Aurora和Kodiak拿到许可,Kodiak已率先在湾区试跑。测试仍须配备人类安全员,车辆原则上不能开进限速25英里以下的道路。Teamsters California已起诉DMV程序缺失,真正的悬念是安全员什么时候能撤。
Spotify拟标记AI艺人并停止推荐,真正收紧的是流量入口
404 Media披露,Spotify正讨论标记AI生成艺人,并停止主动推荐相关内容。标签解决的是告知问题,推荐限制才会影响播放量和商业回报;但规则边界、适用范围与执行时间仍未公开。
Google允许关闭Gemini可见水印:画面更干净,溯源转入后台
Google为Gemini和Flow加入“Media watermark”开关,用户可关闭AI生成内容右下角的闪光水印,但SynthID与C2PA信息仍会保留。它降低了创作者直接使用素材的门槛,也把内容识别从肉眼判断转向机器检测。真正的限制在于:隐形标记能否经受裁剪、压缩和平台转发,以及普通用户能否方便地验证。