人工智能资讯 第107页
聚合当前分类下的最新内容,按时间顺序查看第 107 页精选文章。
Character.AI杀入微短剧赛道,官方公告却查无踪迹
Character.AI悄悄上线三部可对话微短剧,想用聊天粘性切入这个由专业短剧App和大流媒体主导的赛道;但官方渠道近乎沉默,外界常引用的月活时长数据也缺一手出处,这场转型的底气还有待验证。
Ollama融资6500万美元:免费护城河,收费新生意
开源AI工具Ollama完成Theory Ventures领投的6500万美元B轮,累计融资8800万美元,创始人称月活开发者近890万、渗透85%财富500强,团队仅14人。热闹的融资叙事背后,是一年多的开源社区信任争议和被曝光的安全暴露面,Ollama真正要证明的是免费口碑能不能撑住它的云端生意。
邦妮·泰勒“去世”消息先别转:AI 搜索最怕这种半截讣闻
网上出现“Bonnie Tyler dies aged 75”的标题式线索,但仅凭这一句和空摘要,不能把邦妮·泰勒去世写成确定事实。真正该看的不是谁抢先报了讣闻,而是谁给出了可核验来源;这类消息也暴露了 AI 搜索在高敏事实上的软肋:它会整理信息,却未必承担查证责任。
Databricks自测编码智能体:真正决定成本的不是模型单价,是那层叫harness的东西
Databricks用自家数百万行代码库做的内部基准显示,开源模型GLM 5.2已经以更低成本追平Opus 4.8的质量,而决定实际花费的关键变量其实是harness如何裁剪上下文,不是模型的每token价格。这份评测出自一家同时在卖harness切换产品Omnigent的公司,结论可信但不宜照单全收。
AI让代码库重写更划算,但没让人更懂代码
有博主提出,代码库越贴近AI训练数据里的主流范式,AI辅助编程效率越高,这让重写遗留系统重新变得划算。但独立研究显示,AI提升的是任务完成速度,不是开发者对代码库的真实理解——为AI讨好而重写,可能只是把旧技术债换了张更整洁的新皮。
越用越高效,也越用越烦:开发者们正遭遇“LLM疲劳”
开发者Alec Scollon在博客里记录自己对LLM输出产生本能抵触:不是工具出错让他崩溃,而是同样的幻觉、同样的破折号短句、同样的emoji一遍遍出现。这背后有学术论文和Anthropic自己的研究做支撑,说明“效率提升”和“认知负荷上升”正在同时发生,AI辅助编程已经走到一个好用却让人厌烦的阶段。
96分变48分:布朗大学一堂经济学课的AI作弊罗生门
布朗大学经济学教授Roberto Serrano怀疑学生用AI做完带回家期中考试,临时把期末改成现场闭卷,结果班级平均分从96分跌到48分,22名期中满分的学生干脆没来考。这组数字目前只是教授单方陈述,校方尚未介入调查,却已经被两家媒体做成了“AI作弊丑闻”。
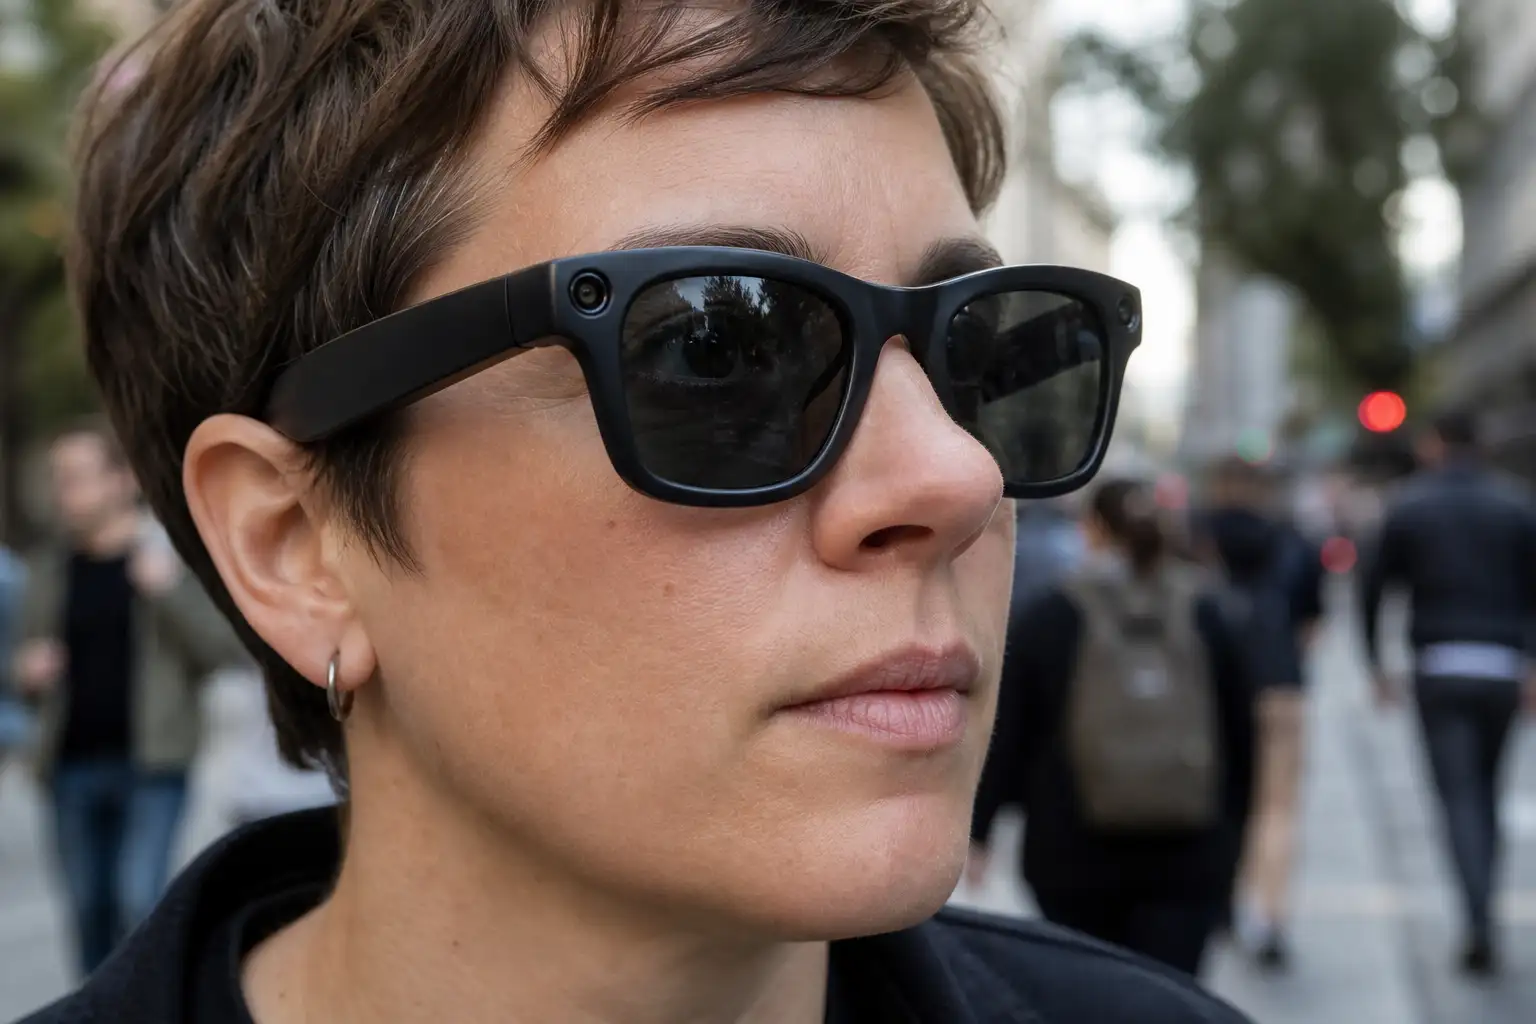
Meta智能眼镜拟“全程感知”:灯不亮,但一直在录
《金融时报》报道,Meta正测试代号“super sensing”的智能眼镜原型,可持续录音并每隔几秒拍照,供用户事后向Meta AI查询周边环境。核心变化不是又出一款AI眼镜,而是把捕捉行为从用户按键触发前移为默认后台常态,LED指示灯计划保持熄灭,隐私边界将决定这类产品能否落地。
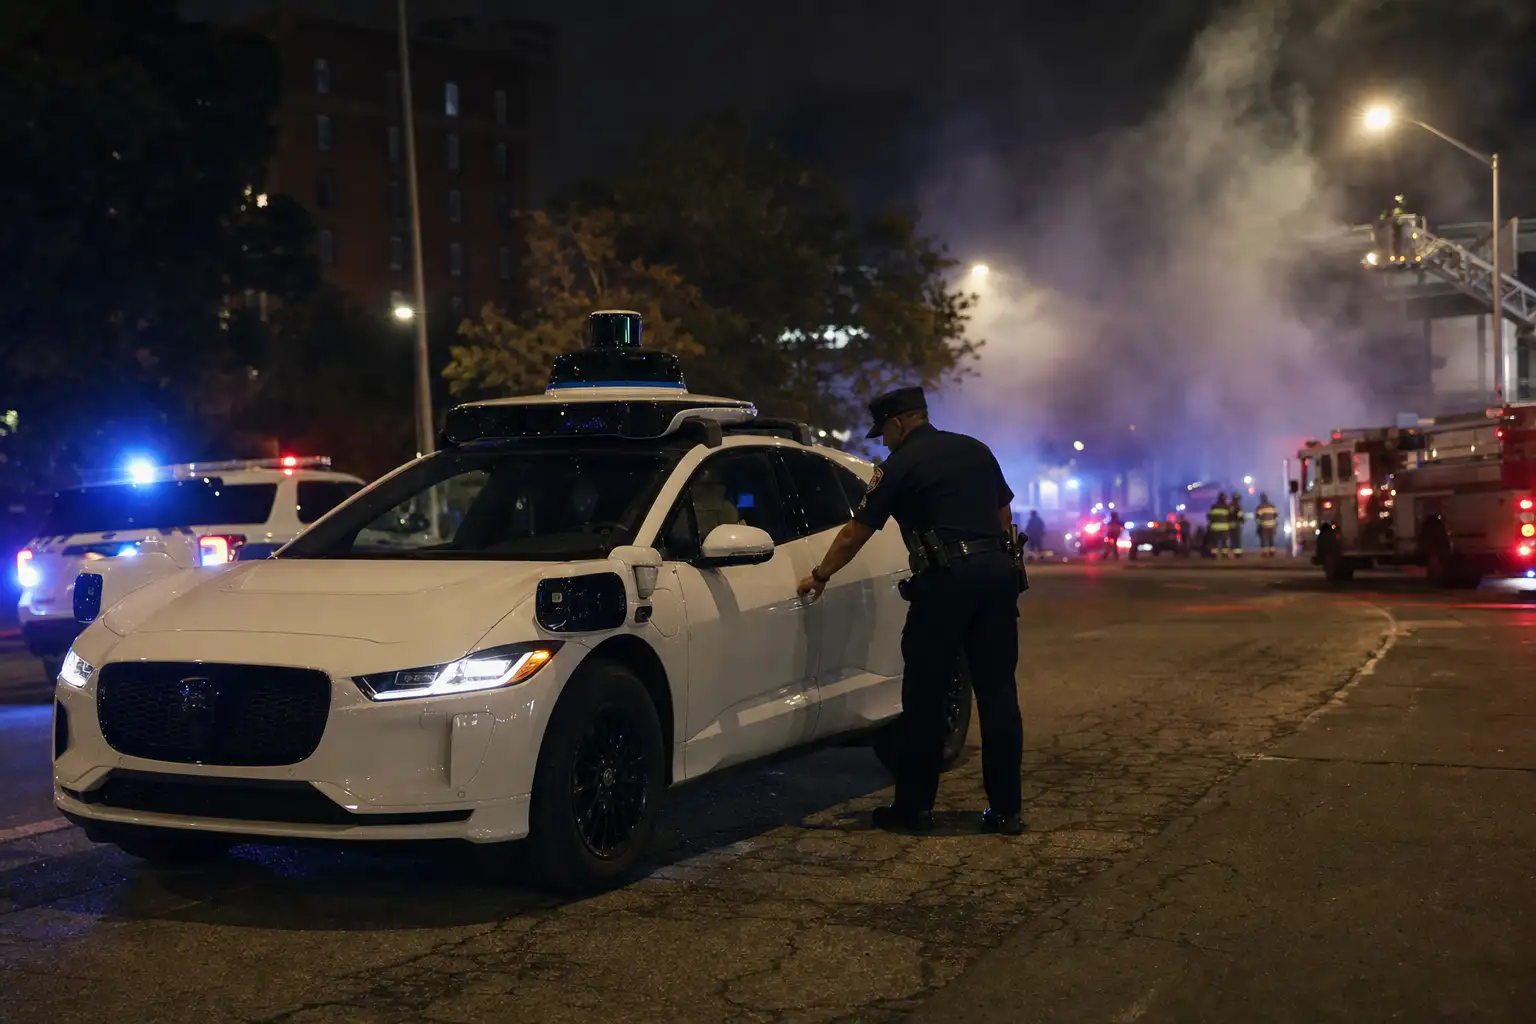
Waymo的应急协议写了三年,救护车照样被堵
NHTSA要求自动驾驶公司月底前解决车辆干扰急救现场的问题,但信里不点名、不设罚则,也没定义什么算合格方案。更扎心的是,Waymo、Zoox、Tesla早在2022到2026年间就已各自发布过应急协议,说明卡壳的不是流程缺失,而是感知和响应能力跟不上纸面承诺。
Lovable一年翻七倍:132亿美元估值背后的算术题
瑞典AI编程公司Lovable正洽谈以132亿美元估值融资3亿美元,较去年12月的66亿美元整整翻倍,一年内估值涨了逾7倍,Menlo Ventures预计领投。这笔交易还在洽谈阶段,单一信源尚未交叉确认,但已披露的用户和ARR数据能大致算出这轮估值对应约26倍营收倍数,高于多数同类公司。
OpenAI亲手否决自荐基准:SWE-Bench Pro三成任务被判'不及格'
OpenAI对自己去年力荐的编程基准SWE-Bench Pro做了一次自我审计,认定约30%的公开任务存在缺陷,当场撤回此前的推荐。更值得留意的是,部分问题GitHub上早有编号明确的报告,而这次审计的裁判和运动员,某种程度上是同一批人。
OpenAI立下国家安全三条红线,问题是谁来验证
OpenAI发布《国家安全原则》,同时披露一个月内与八国及欧盟机构建立网络防务信任合作、扩大生物安全模型访问权限,其国防业务已包含一份两亿美元级合同。但公司自证式的“不用于监控、不用于自主武器”承诺至今没有第三方审计,参议员沃伦已在国会追问合同细节能否公开。
AI写的PR描述,为什么比没有还糟?
工程师Kenton Varda在团队内部禁用AI生成的PR描述、commit信息和issue文字,理由是这类文本详细复述代码本身就能看出的细节,却漏掉审查者真正需要的意图说明。问题不是AI写得不够细,而是它擅长的信息维度和PR消息的核心价值本来就不在一个频道上。
麦康奈尔病床假照翻车:Google水印赢了一局,但这场胜利经不起细看
一张米奇·麦康奈尔病床惨状的AI假图疯传后被Snopes借助Google的SynthID水印戳穿,这被称为'罕见但重大的胜利'。但破案的关键其实是生成工具主动参与水印计划,而非系统主动识破谎言,这恰恰暴露了深伪检测的真实覆盖率有多窄。
8分钟数据、23亿估值:机器人的ChatGPT时刻是真是假
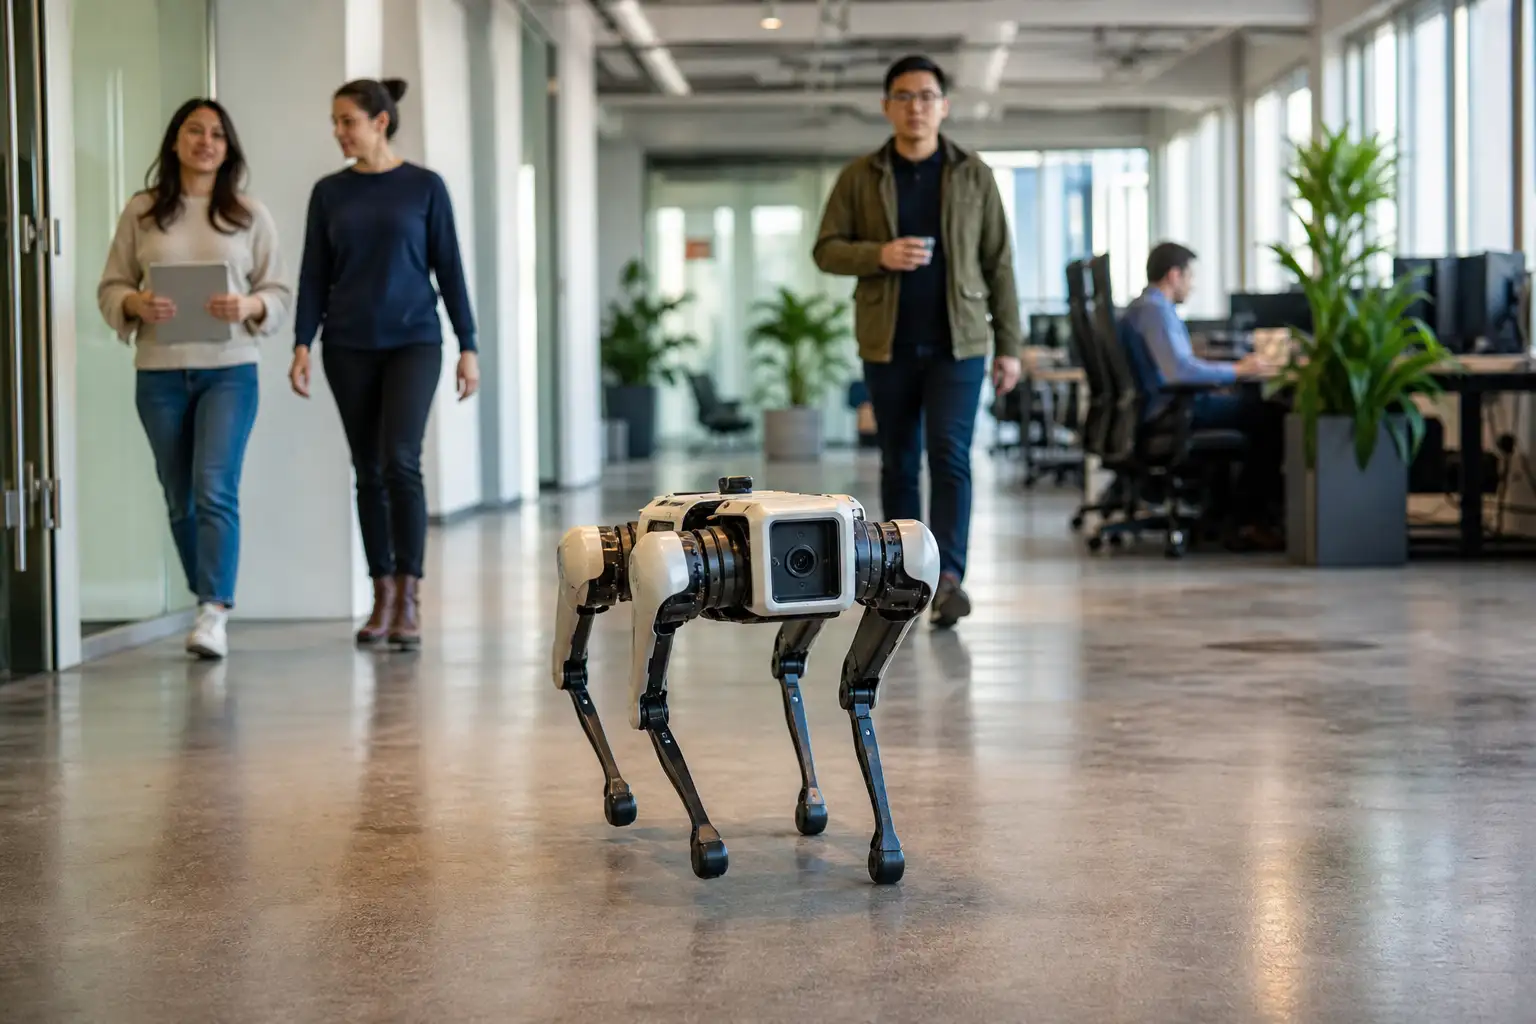
General Intuition称用视频游戏动作数据训练的模型,只需8分钟真实数据微调就能让四足机器人在办公室里zero-shot行走,公司借此叙事一个月内把估值从传闻的20亿美元推到23亿美元。但目前所有证据只来自公司自证的单一演示,没有第三方复现,也没有披露失败率和任务边界。
Grok 4.5发布:马斯克对标错了一代,还有个神秘模型全程领跑
xAI发布Grok 4.5,定价比Opus级模型便宜不少,但摊开官方自己公布的跑分表会发现,马斯克拿来对比的是旧一代Opus 4.7,而不是同代的Opus 4.8——在Grok重点强调的SWE Bench Pro测试里,Opus 4.8其实领先Grok 4.5。榜单里还有一个叫Fable(max)的模型全程夺冠,却没人解释它是谁。
微软开源Flint:AI画图表,先过编译器这一关
微软研究院联合人大IDEAS Lab开源可视化中间语言Flint,用语义类型和编译器把AI生成的图表规格翻译成Vega-Lite、ECharts、Chart.js配置。它省的是调试底层参数的成本,不是画图能力,效果全看数据语义标注是否到位。三个后端渲染能力并不对等,Flint也不是BI工作流的替代品。
Google 出的考卷,自家 Gemini 却排到第五
Google 更新了自研的 Android 开发基准 Android Bench,新增 Claude Fable 5、GPT 5.5 等八款模型,结果自家 Gemini 3.1 Pro 反而跌到第五名,排在 GPT 5.4、Claude Sonnet 5 和 Claude Fable 5 之后。更值得琢磨的是,这份自己出题的榜单,本身也在改版中悄悄挪动过分数。
点一下'不感兴趣'能砍掉八成内容,但TikTok算法几天就把你打回原形
美国西北大学团队用90个傀儡账号实测发现,TikTok的'不感兴趣'按钮能让同类内容减少约84%,远胜单纯划走的48%,但只要用户后来多看几秒同类视频,算法就会悄悄把内容推回来。Instagram、YouTube也有类似的半吊子控制工具,说明这不是TikTok一家的产品瑕疵,而是整个推荐系统把'看了多久'看得比'说了什么'更重。
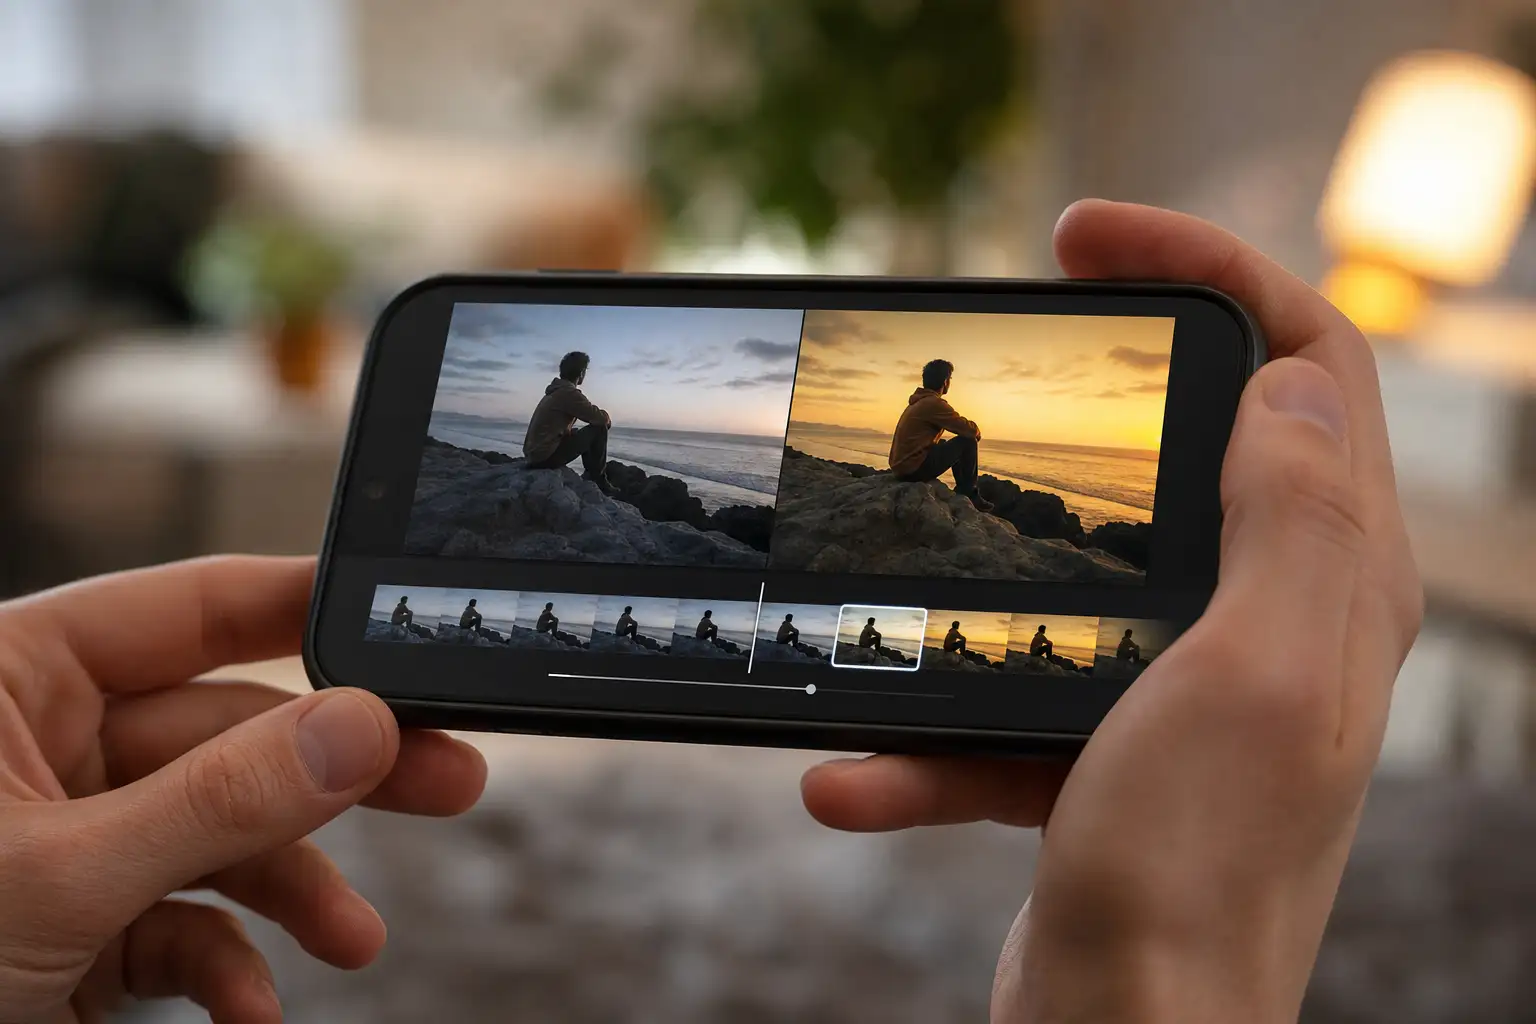
Google Photos上新AI剪辑术,水印真挡得住深度伪造吗
Google Photos新增Video Remix,靠Gemini Omni几秒内给旧视频补光、换背景、上艺术风格,14国订阅用户先用。但三个月内相册里已经堆了三个功能相近的AI生成工具,唯一的安全网SynthID水印,连Google自己都承认防不住裁剪和转码。
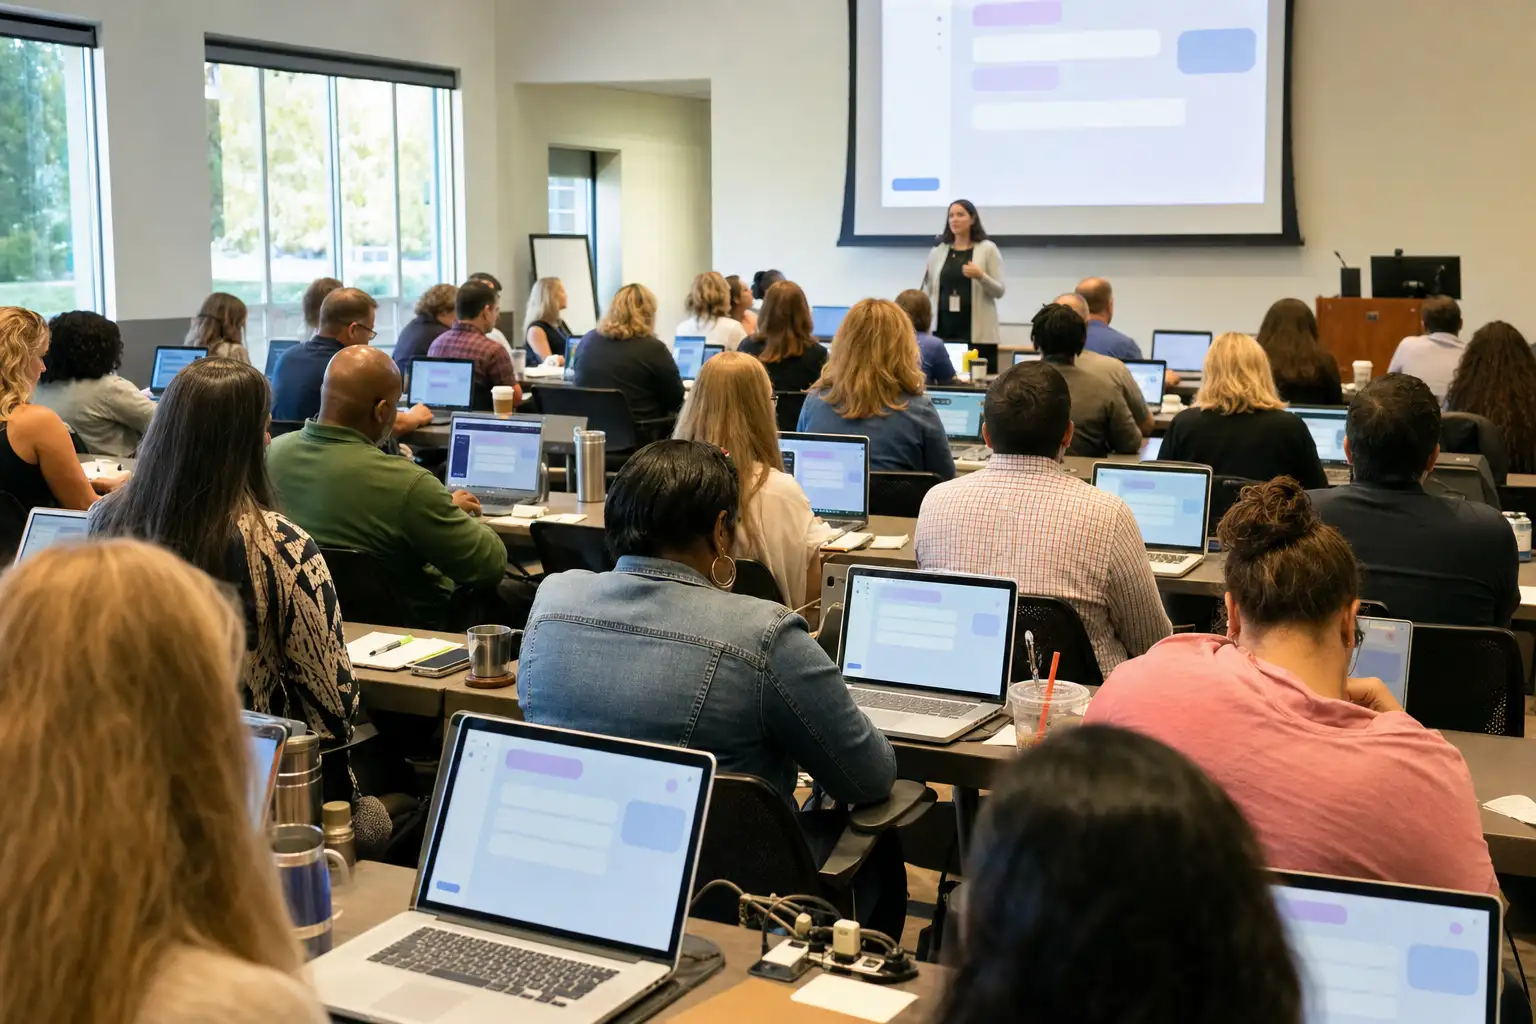
OpenAI教师AI培训营开进8城,但69%教师仍无人指导
OpenAI Academy联合Walton Family Foundation从7月8日起在美国8座城市为1600多名K-12教师办线下AI培训营,但其宣传语里的“教师用AI每周省5.9小时”这一数据挂错了报告名,同一批调研更显眼的发现——69%教师从未获得任何AI教学指导——反而没被提及。一场线下workshop,填不平这么大的缺口。