2026 年 10 月末,全球消费级内存涨价潮愈演愈烈,OpenAI 首席执行官 Sam Altman 却在此时建议把内存集中在机房而非个人桌面。他在 10 月 29 日播出的播客《Cheeky Pint》第 39 集中与 John Collison 对话时直言,把全球有限的 DRAM 分散在个人电脑里且只有 5% 的时间被使用,从全局分配来看相当糟糕。这番话被多家媒体浓缩为“内存放在数据中心比放在办公桌上更好”的惊悚标题,听起来像科技高管又一次脱离大众的傲慢表态。
但如果把进度条拉回播客第 29 分钟的原始语境,就会发现 Altman 并没有呼吁剥夺普通人的电脑内存。他的火力非常集中,瞄准的是在个人设备上运行本地开源模型推理(Local inference)的技术风潮。在云端巨头疯狂吞噬存储产能的当下,Altman 搬出利用率经济学,真正算计的是如何守住云端 API 与订阅制的商业护城河,同时为数据中心抽干消费级硬件供应做合理化辩护。
靶心不是游戏玩家,而是跑在本地的开源大模型
媒体标题很容易让人误以为 Altman 连玩家的电竞主机或日常办公本都要管。实际上,他在播客里点名批评的是这样一种行业直觉:很多人渴望本地推理,认为只要有了开源模型、能在自己的电脑上跑起来,就不再需要数据中心里那些庞大设施。Altman 认为,在当前供应极度受限的环境下,把稀缺内存留在本地跑模型是低效的,应当追求云端最大化利用率。
换句话说,普通 PC 用户只是被舆论流弹波及的路人,真正的靶子是以开源模型和端侧硬件为代表的去中心化 AI 路线。如今无论是微软的 Surface RTX Spark Dev Box,还是苹果新推出的触控屏 MacBook Pro,都在强化本地算力;开源社区更是在想方设法把大模型塞进个人显卡和内存。只要用户能用本地硬件免费跑通开源模型,OpenAI 按 token 收费的云端账单就会缩水。
这种话术直接激怒了开源与硬件社区。在 Reddit 的 r/LocalLLaMA 社区,开发者们专门发起讨论帖反驳称,Altman 把本地推理定性为糟糕的资源配置,本质上是云厂商在打压开源替代方案。批评者一针见血地指出,云巨头最希望看到的结果,就是迫使所有开发者和用户从拥有算力退化为租用算力。
3:1 的晶圆黑洞,数据中心如何抽干你桌上的内存
Altman 把内存短缺归咎于个人电脑闲置,却隐去了供应链源头真正的吞金兽。你的笔记本电脑和手机之所以越来越贵,不是因为极客们在家攒机买走了太多内存条,而是 AI 数据中心从物理制造源头抽干了产能。
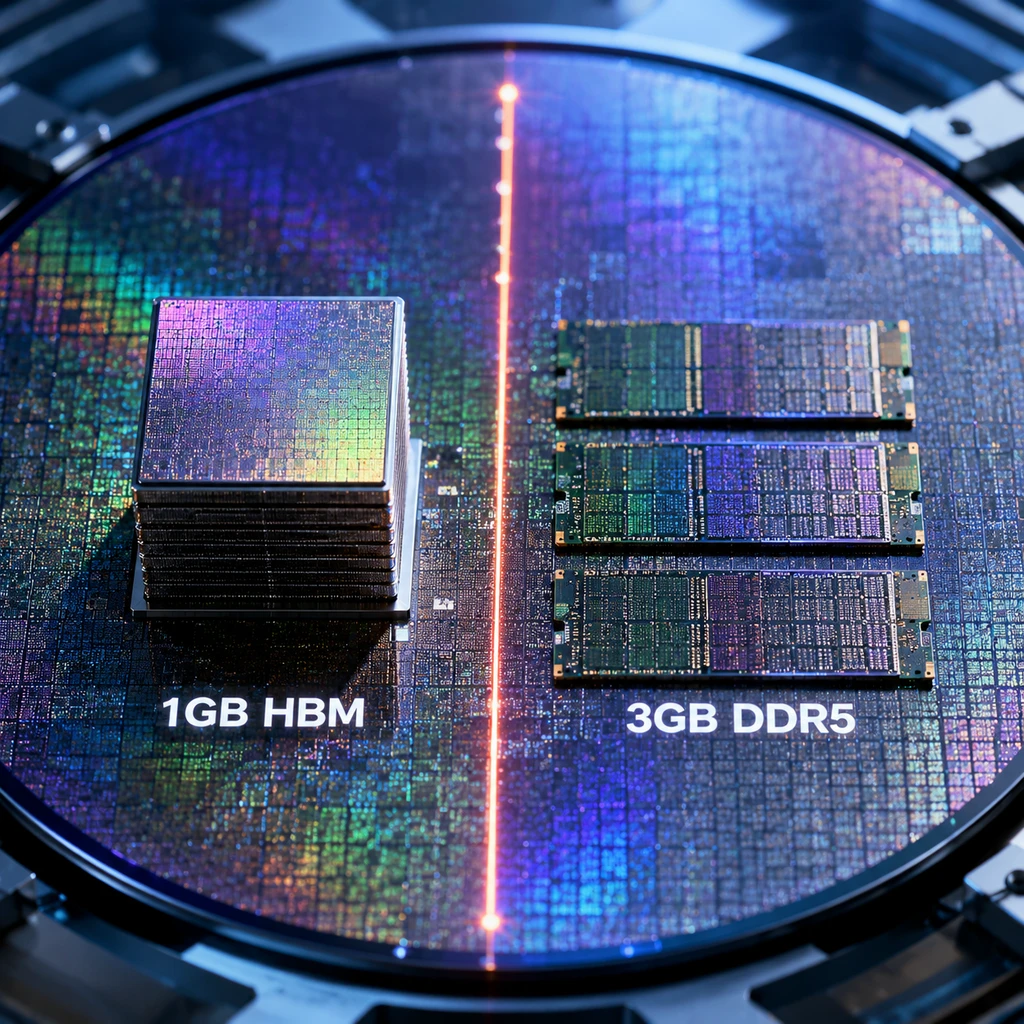
存储芯片行业历史上经历过多次剧烈的周期性暴涨暴跌,三星、SK 海力士和美光在新建晶圆厂时极为谨慎。面对 AI 算力爆发,存储大厂的策略是不轻易扩建新厂,而是把现有的先进晶圆产能,从传统的消费级与 PC 级内存(如 DDR5)强行拨给高利润的服务器内存和高带宽内存(HBM)。
这里有一个普通消费者极少注意到的硬核物理限制。根据美光披露的制造数据,生产 HBM 每比特消耗的晶圆产能大约是同工艺 DDR5 的 3 倍(3:1),而且未来新一代 HBM 的晶圆消耗比例还会进一步扩大。这意味着数据中心每拿走 1GB 的 HBM 产能,消费级市场在物理上就会凭空消失 3GB 的常规电脑内存。
更让消费电子厂商绝望的是,未来几年的产能早已被云巨头用长协支票买断。SK 海力士在 2026 年第三季度业绩报告中明确表示,HBM4 正成为其主流产品,公司已经与云服务商及 OpenAI Stargate 等项目签下长期协议,提前锁死了 2027 至 2028 年过半产能。SK 海力士同时预测,内存需求大于供应的局面将一直持续到 2030 年,而三星也预计短缺至少延续到 2028 年。
研究机构 TrendForce 在 2026 年 9 月 30 日的报告印证了这场挤压的直接后果:由于制造产能优先向服务器倾斜,2026 年第四季度传统 DRAM 合约价格环比上涨 10% 至 15%,且 2027 年全球 PC DRAM 的总供应量将随产能转移而出现实质性下降。从苹果再度上调 MacBook Neo 的教育优惠价,到 iPhone 18 Pro 等智能手机面临的涨价压力,买单的都是普通消费者。
5% 利用率的经济学诡辩,与拒绝交出控制权的底线
既然产能是被数据中心抽干的,Altman 抛出的“个人电脑 DRAM 只有 5% 利用率”就经不起推敲。这个 5% 的数字没有任何公开数据支撑,而且犯了一个常识性错误:它把个人电脑当成了单一功能的 AI 推理机。
算力集中化解决的不是硬件短缺,而是云巨头的商业焦虑。
在真实的桌面场景里,无论是开发者的工作站还是玩家的电脑,那 32GB 或 64GB 的内存绝不会在跑完本地大模型后就断电吃灰。同一根内存条,白天要承载代码编译、3D 渲染或视频剪辑,晚上要跑大型游戏,中间穿插着处理本地 AI 任务。这种多功能复用恰恰是通用个人计算设备诞生半个世纪以来的最高效率形态。
退一步讲,即便云端机房的吞吐效率确实高于个人桌面,效率也从来不是决定算力分配的唯一标准。本地部署与端云混合架构(例如苹果采用的端侧优先、复杂请求上云的路线)之所以不可替代,核心在于三个云端无法提供的底线价值:
- 绝对的数据隐私.医疗、金融、代码与个人私密文档无需离开本地硬盘,彻底杜绝云端泄露或被用于模型训练的风险。
- 确定的边际成本.硬件是一次性沉没成本,跑一万次推理也是只费电费,不用担心云厂商在垄断市场后单方面调高 API 价格。
- 完整的模型控制权.本地开源模型不会被厂商在后台暗中更换权重、降低智商,也不会因为一次内容审查策略调整而突然拒绝服务。
- 提醒.对于计划在未来一年内升级工作站、攒机跑本地模型,或是采购大内存笔电的开发者与重度玩家,不要指望内存价格会在短期内回落;在 2026 年 Q4 合约价已涨 10%–15% 且 2027 年 PC 内存供应明确萎缩的背景下,按需尽早锁定硬件配置,比等待存储大厂释放产能更切实际。
这场围绕内存条展开的口水战,揭开的是未来四年计算产业最核心的矛盾。当 SK 海力士与美光的晶圆生产线在 2030 年前都向数据中心倾斜,个人计算设备将不得不经历一段高昂的硬件通胀期。接下来最值得盯紧的变量,是端侧硬件厂商如何在物料成本飙升的夹击下保住大内存机型的定价,以及开源社区能否通过极致的模型量化压缩技术,在有限的桌面内存里继续打赢这场算力游击战。