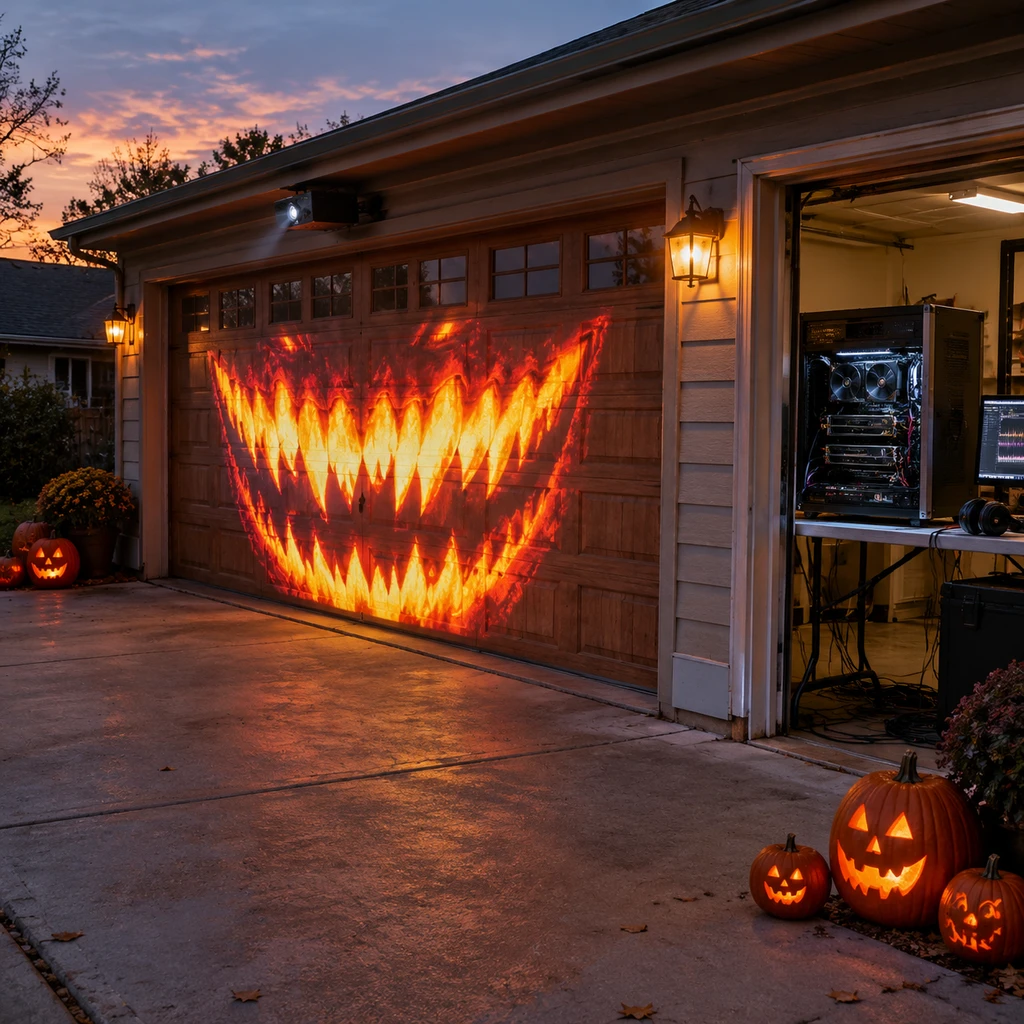
把自家车库门变成一艘脾气暴躁、听见请和谢谢才肯给糖的沉船海盗,听起来像个温馨的万圣节极客手工。2026年10月30日,NVIDIA 员工 Rick Grandy 在 Hugging Face 放出 MonsterHouse 项目博客,宣布用一套全离线开源模型把这件事跑通了。但只要掀开这扇木门的底牌就会发现,所谓的单机本地运行,里面塞着 NVIDIA RTX PRO 6000 Blackwell Max-Q 和 NVIDIA RTX PRO 4000 Blackwell 两张顶级专业显卡。
这场秀真正的看点不在万圣节讨糖,而在 NVIDIA 如何借一个玩具,展示一条与 OpenAI Realtime API、Google Gemini Live 截然不同的本地多模态数字人路线,以及这条路线眼下真实的算力代价。
两张 Blackwell 专业卡撑起的车库门
MonsterHouse 的交互链路很清晰,全部由 NVIDIA Nemotron Voice Agent 在单台工作站上统一调度。系统用 Nemotron Speech ASR(nemotron-speech-streaming-en-0.6b.q8_0.gguf)把门外访客的语音转成文字,交给挂了 LoRA 适配器的 Nemotron 3.5 Bolt E4B 4GB 生成带海盗腔调的回复,再由 Magpie TTS Zeroshot 吃进 3至10秒 的参考音频做零样本流式语音合成,最后通过 Audio2Face-3D 在 Unreal Engine 5 里驱动 Maya 制作的木门嘴部骨骼动画。视觉侧则配了 YOLO 与 ByteTrack 统计追踪人数,外加 Nemotron 3 Nano Omni(30B-A3B-Reasoning-BF16)负责识别访客身上的万圣节服装。
普通开发者如果想在家里复刻这个车库门,很快就会撞上显存与算力墙。作者在工作站里插了两张卡做严密的物理隔离,RTX PRO 6000 Blackwell Max-Q 专门跑语言和语音 AI 流水线,RTX PRO 4000 Blackwell 专门跑 Unreal Engine 5 渲染与 Audio2Face-3D(并留出 100 毫秒缓冲补偿对齐音画),为的是防止大模型推理抢占算力导致画面掉帧。
翻开 nemotron-voice-agent 的官方仓库,硬件账单更加诚实。其默认的本地 NIM 部署方案需要约 80 GB 显存;哪怕退到基于本地 vLLM 和 NeMo-Speech.cpp 的轻量单卡方案(即 Nemotron 3.5 Lightning 工作站配置),门槛也卡在至少 28 GiB 可用显存。
- 提醒.把云端多模态搬回本地,省下的是按秒计费的 API 账单,付出的却是起步 28 GiB 显存与双卡算力解耦的硬骨头。
名字叫 4GB 的模型装不下 4GB 显存
支撑这扇木门耍嘴皮子的大脑,是 NVIDIA 在 2026年10月23日 刚发布的 Nemotron 3.5 Bolt E4B 4GB。这个名字极容易让人误以为一张 4GB 显存的旧显卡就能跑起来。实际上,它基于 Apache-2.0 协议的 Gemma-4-E4B-it 做后训练,总参数量 8B、有效参数量 4B,采用允许商用的 OpenMDW-1.1 许可证并支持 64K 上下文;名字里的 4GB 指的是 4-bit 量化版本,而官方放出的 Nemotron-3.5-Bolt-E4B-Q4_K_M.gguf 文件体积就高达 6.18 GB,模型卡里甚至没有给出最低显存承诺。
NVIDIA 造这个小模型,目标非常精准,就是为了喂给本地对话 Agent 和游戏 NPC。从 NVIDIA 使用 NeMo Gym 测得的 Q4_K_M 基准数据看,这种定向裁切刀法极其明显。
| 评估基准 | Nemotron 3.5 Bolt E4B 4GB | Gemma 4 原版 | Qwen3.5 4B |
|---|---|---|---|
| RoleBench(角色扮演) | 71.21 | 60.51 | 52.35 |
| IHEval(指令遵循) | 82.40 | - | - |
| MultiChallenge(多轮对话) | 55.60 | - | - |
| BFCL-v3(工具调用) | 67.31 | - | 70.56 |
| Tau2-Bench(智能体任务) | 52.32 | - | 61.74 |
| 64K RULER(长文本检索) | 85.76 | - | 95.37 |
为了把海盗船的坏脾气训出来,作者还用大模型合成并筛选了超过 5000 条多轮对话,花一两个小时单训了 LoRA 适配器。你可以清楚看到 NVIDIA 的取舍,它在工具调用(BFCL-v3 67.31)、复杂任务(Tau2-Bench 52.32)和长文本(64K RULER 85.76)上干脆让步于 Qwen3.5 4B,也不用体积更大的 Qwen3 30B-A3B 或 Qwen 3.6 35B-A3B,而是把算力全砸在角色扮演(71.21 分)和指令遵循上。车库门不需要帮你写代码查财报,它只需要记住你有没有说请,并在恰当的时候骂骂咧咧地把糖交出来。
脱离四张 H100 之后的 1.70 秒延迟博弈
实时语音交互最残酷的考场是延迟。一句抱怨如果隔了两秒才从木门嘴里吐出来,小孩早转身去敲邻居家门了。
在 NVIDIA 官方宣传册上,nemotron-voice-agent 能跑出单流 0.79 秒(64 并发流约 1.0 秒)的惊艳端到端延迟。但那是把 ASR、TTS 和 LLM 拆开部署在 4 张 H100 GPU 上,并开启投机语音处理才换来的实验室数字。一旦落回单台双卡工作站,还要带上零样本声音克隆,物理定律立刻接管现场。
在 MonsterHouse 的实测中,系统先等待 300 毫秒静音来判定访客把话说完(NVIDIA 整套语音流水线的轮次检测底层包含 200 毫秒停顿检测器、320 毫秒尾随静音独立 ASR 定稿以及 1 秒 Smart Turn 兜底机制),随后走完 Bolt Q4 推理加 TTS 合成,中位延迟直接涨到了 1.70 秒。
为了不让场子冷掉,作者用了一个老派游戏策划的障眼法。他把高频寒暄和讨糖笑话提前写进文本库、录好音频,一旦命中熟悉场景就直接跳过生成与合成,把缓存回复的中位延迟压回 0.72 秒,同时在后台控制台留了一个人类直接拿麦克风夺舍替说的开关。连作者自己也承认,如果开发者的算力不够,最务实的办法还是退回 ASR 加 Python 路由配预生成音频的传统套路。
为什么宁肯背着两张卡也不调云端 API
既然本地跑得这么重,为什么不直接调一行 OpenAI Realtime API 或 Google Gemini Live 的代码?
答案藏在《史记》那句老话里,天下熙熙,皆为利来。只是在 AI 基础设施的牌桌上,云厂商挣的是过路费,NVIDIA 挣的是买路钱。
云端卖的是省心黑盒,本地卖的是带锁的私有产权。
OpenAI(如 gpt-realtime-2.1-mini)和 Google Cloud 的原生端到端语音确实接起来极快,但它们把模型和你的语音数据全锁在云端黑盒里,连实时自定义声音克隆(Google 需 10至20秒 PCM 音频)都只向符合特定资格的客户开放,且一律不支持本地自托管。反观 NVIDIA,虽然 Magpie Zeroshot 同样需要申请访问权限(另一款 Magpie Flow 则仅支持离线),但它允许你把 3至10秒 的声音克隆、角色大脑和 UE5 渲染管线全部锁进内网机柜,断网也能跑。
这对个人极客来说过于奢侈,但对主题乐园、数字展厅、游戏工作室以及对隐私极度敏感的医疗金融终端来说,却是目前唯一能买到的全栈自控方案。NVIDIA 放出免费的 AI Blueprints 和魔改后的 Gemma 4 小模型,醉翁之意从来不在几行开源代码,而在替自家的 Blackwell 专业级工作站显卡开辟大模型训练之外的边缘推理疆土。
- 结论.Nemotron Voice Agent 真正的买家不是在家哄孩子的极客,而是那些既想要实时数字人、又绝不肯把数据上传给 OpenAI 的商业场馆与硬件采购商。
只是这扇万圣节木门离真正无人值守还差最后一口气。截至博客发布,MonsterHouse 的定制控制代码尚未打包开源,被拿来测试 Nemotron 3 Nano Omni 视觉识别的还是一段五只穿万圣节服装的绵羊合成视频,真正的夜间车道光线与熊孩子群访实测还没交卷。等万圣节当晚灯光亮起,这台塞着两张顶级显卡的暴躁车库门能不能扛住真实世界的喧闹,才是检验本地多模态管线成色的真考场。